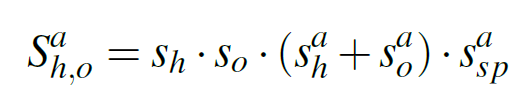Reference

HU, Yihan, et al. Planning-oriented autonomous driving. In: Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. 2023. p. 17853-17862.

OpenDrive Lab에서 투고한 현재 717회 가량 인용된 자율주행 논문이다.
본 논문은 모듈러 E2E를 제안하였으며 BEV 쿼리를 전달하여 Planning 출력을 만들어내는 구조이다.
이후 Nvidia의 PARA-Drive의 베이스라인으로 활용되었다.
[github] https://github.com/OpenDriveLab/UniAD


GitHub - OpenDriveLab/UniAD: [CVPR 2023 Best Paper Award] Planning-oriented Autonomous Driving

[CVPR 2023 Best Paper Award] Planning-oriented Autonomous Driving - OpenDriveLab/UniAD

github.com


Abstract

대부분 잘 알려졌다시피 자율주행 시스템은 인지(Perception), 판단(Planning & Decision), 제어(Control)의 구조의 순차적인 모듈로 이루어져 있다.
해단 논문에서는 제어 이전까지, 인지를 통한 예측, 그리고 판단(Planning)까지의 모듈 구조로 E2E 네트워크를 구성하였다.
보통 현재 자율주행 분야에선 인지 분야만 해도 여러가지 인식 기능을 필요로 하는데, (객체 인식, 공간 인식, BEV 인식, Occupancy 인식 등)
기존의 접근 방식은 각각의 작업마다 독립적인 모델을 따로 활용하거나, 멀티태스크 방식(multi-task paradigm)으로 동일 Backbone에 여러가지 헤드를 연결하는 방식으로 이를 해결하였다. (ex. 테슬라에서 옛~날에 제안했던 Hydra-MDP... NVLab의 네트워크 말고)
 
그러나 이러한 방식은 오차의 누적(accumulative errors) 또는 각 기능 별 동시 학습했을 때의 긍정 효과를 활용할 수 없다는 문제가 발생한다.
**예를 들어, 인지 네트워크 모듈과 판단 네트워크가 동시에 학습되지 않는다면 결국 각 기능의 Loss를 활용한 전체 프레임워크의 gradients를 업데이트 하는 것이 불가능하다.
**이는 인지 -> 판단의 구조를 구현은 할 수 있으나, 결국 자율주행에서 최적의 판단/제어를 위한 인지를 해야한다는 관점에선 각 기능을 따로 학습하는 disjoint는 불합리하다는 것으로 이해하였다.
 
이에 반해, 저자는 자율주행의 목표인 ‘Planning’ 중심의 프레임워크를 설계하고 최적화할 것을 제안하였다.
이를 위해 인지 및 예측 모듈의 구성 요소를 다시 점검하고, 각 작업이 Planning에 기여하도록 우선순위를 재정립하였다.
 
제안된 Unified Autonomous Driving (UniAD)는 자율주행에 필요한 풀스택 Tasks를 하나의 네트워크 안에 통합한다. 네트워크 내부의 정보 전달은 query 형태로 이루어지며, 각 Task는 유기적 협업을 가능하게 한다.
 
기존의 바운딩 박스 방식과 달리, query 기반 표현은 더 넓은 수용 범위(receptive field)를 가지며, 상위 모듈의 예측 오류가 플래닝에 누적되는 것을 완화할 수 있다.
또한, query는 다양한 상호작용(예: 다중 에이전트 간 관계)을 더 유연하게 모델링하고 표현할 수 있다.


Introduction

대부분의 기업들은 임베디드 칩의 리소스가 허용하는 범위 내에서, 각 작업별로 독립적인 모델(standalone model)을 배치한다.
이러한 설계는 팀 간 협업 측면에서 개발 난이도는 완화하나 모듈 간 정보 손실, 오차 누적, 피처 정렬 실패(feature misalignment) 등의 문제가 발생할 수 있으며, 이는 각 모듈이 독립적으로 최적화되기 때문이다.
 
여기서 한 단계 진보된 방식은  여러 작업을 멀티태스크 학습(MTL, Multi-Task Learning)으로 통합하는 것이다.
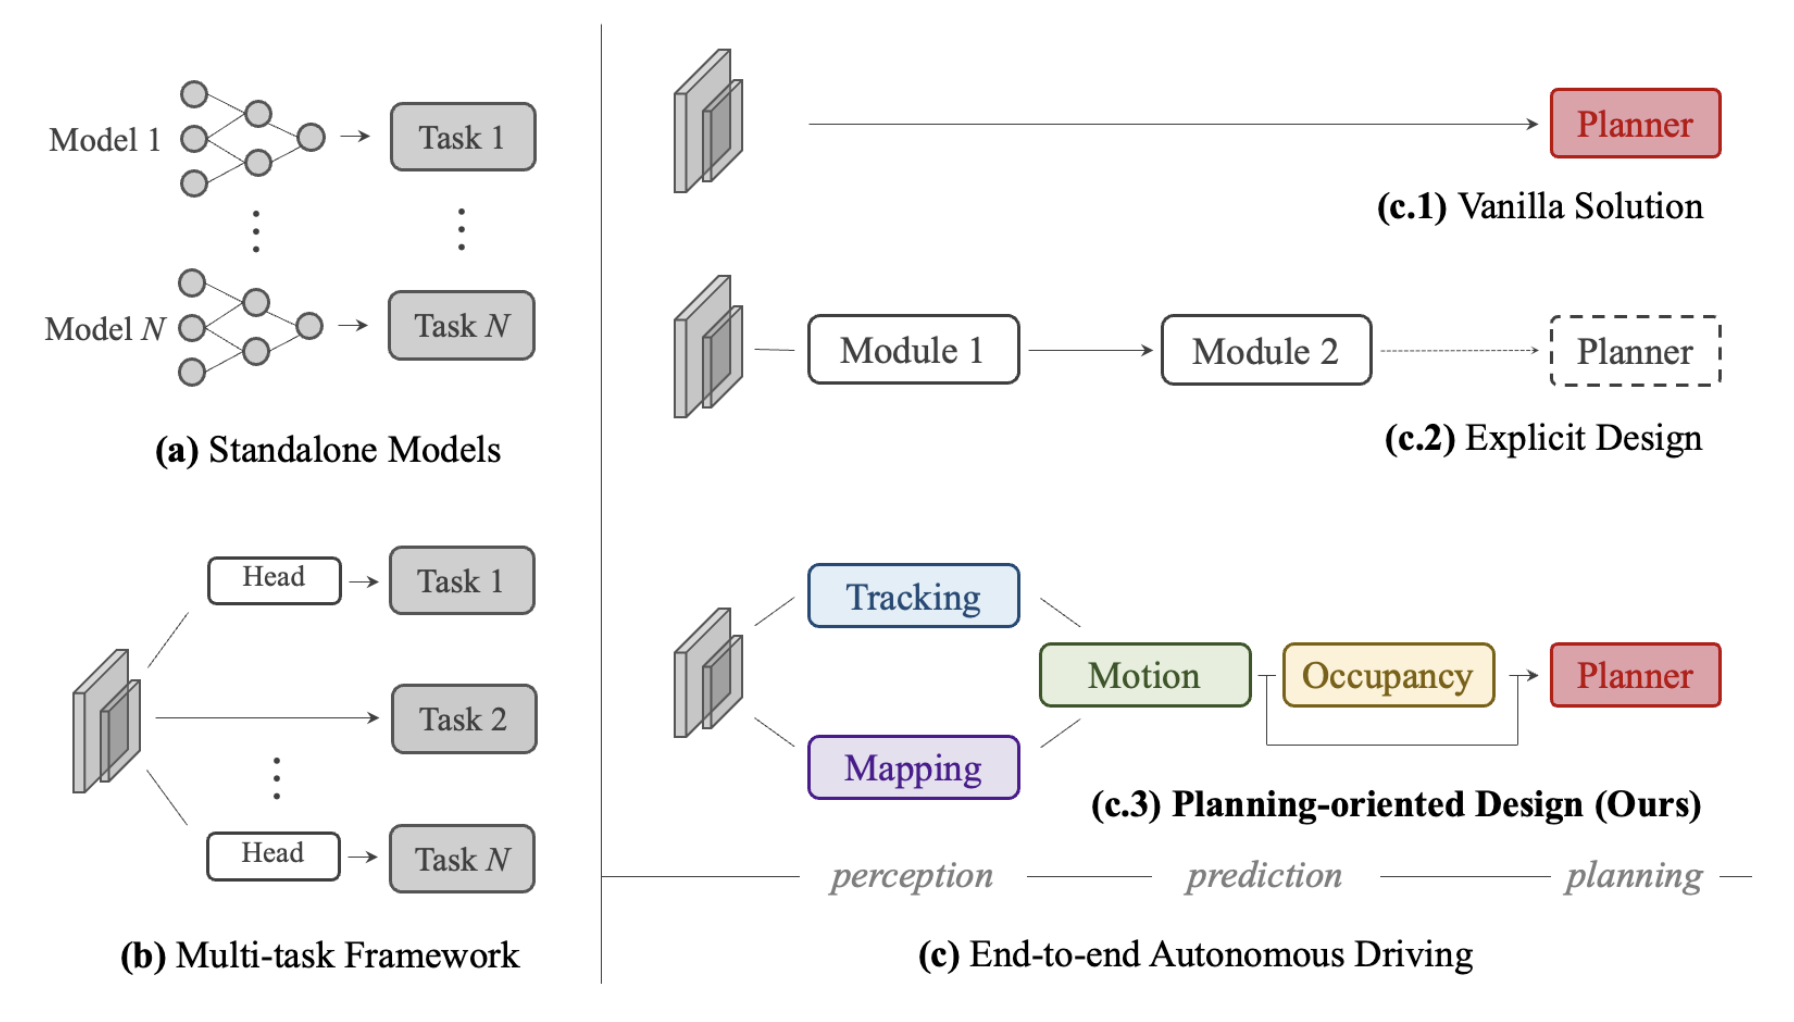
그림 1. 자율주행 프레임워크 설계 방식 비교

(a) 대부분의 산업계 솔루션은 작업별로 독립적인 모델을 각각 배치한다.
(b) MTL 방식은 하나의 backbone을 공유하면서, 태스크 별 헤드를 구성한다.
(c) E2E 패러다임은 인식과 예측 모듈을 하나의 체계로 통합한다. 기존의 시도들은 다음 두 가지 중 하나를 채택했다:
    (c.1) 플래닝을 직접적으로 최적화하는 방식
    (c.2) 일부 구성 요소만 포함하여 시스템을 설계하는 방식
이에 반해, UniAD는 (c.3)과 같이 planning-oriented로 시스템을 설계하고, Planning을 위해 선행 작업들을 체계적으로 구성하는 것이 바람직하다고 주장하였다.

이는 위 그림의 (b)처럼 하나의 공유된 feature extractor에 여러 task-specific head를 붙이는 방식이다.
이 방식은 일반적인 컴퓨터 비전 분야 뿐만 아니라, Transfuser, BEVerse와 같은 자율주행 연구에서도 널리 활용되며,
모빌아이, 테슬라, 엔비디아 등의 기업에서 제품화한 사례들도 존재한다.
MTL에서는 작업 간 공동 학습을 통해 더 추상적인 피처를 공유하고 새로운 태스크로 손쉽게 확장할 수 있으며 임베디드 연산 비용도 절감할 수 있다.
하지만 이러한 방식은 GT가 서로 정반대의 기울기를 역전파하는 ‘negative transfer’ 현상이 발생할 수도 있다는 문제를 안고 있다.
 
이에 반해, E2E 자율주행의 등장은 인지, 판단, 제어의 모든 모듈을 하나로 통합하려는 흐름이다.
이 중 제어는 사고로 직결되기 때문에 매우 민감하며, 테슬라도 아직까지는 rule-based 방식으로 구현하였다.
이를 고려하여 판단까지를 E2E라고 했을 때 헤드의 선택 뿐만 아니라 시스템 전체가 ‘planning-oriented’로 설계되어야 한다.
이렇게 구성하면 오차가 누적되지 않고, negative transfer도 피할 수 있다.


** Negative transfer를 피할 수 있다고 주장하는 이유

더보기

아래에서 다시 설명하겠지만 Table 2의 ablation 실험 결과에 따르면, 각 Task를 추가함에 따라 다른 Task의 성능이 향상되는 Positive knowledge Transfer 효과가 발생하였다.

따라서 MTL로 학습한 모델과 달리 예측/플래닝 성능은 향상시키면서 인지 성능에 유의미한 하락이 발생하지 않는 모습을 보였기 때문에 Negative transfer가 발생하지 않는다고 주장하였다.
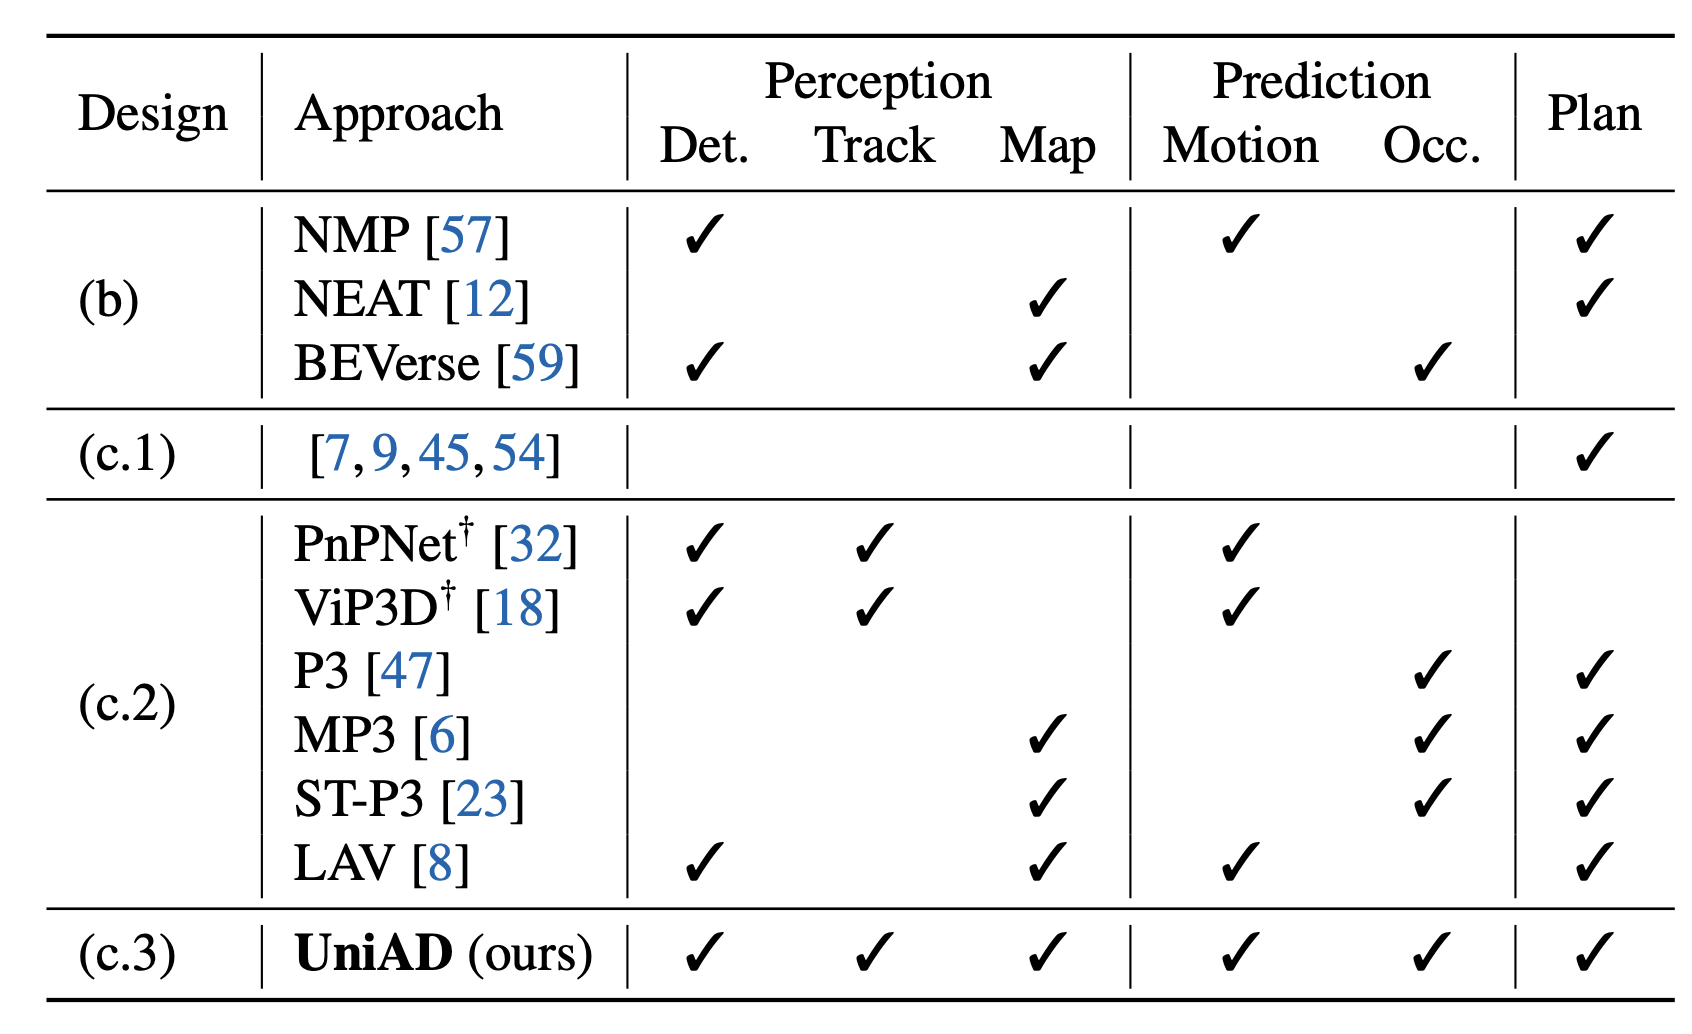
Table1. 기존 연구들과 UniAD에 포함된 요소 기술들 요약


엔드투엔드 패러다임에서의 한 예는, 감지나 예측에 대한 supervision이 없이 바로 주행 궤적을 예측하는 ‘tabula-rasa’ 방식이다 (그림 1(c.1)).
선행 연구들은 이 단순한 구조가 closed-loop 시뮬레이션에서 어느 정도 유효함을 입증했다.
하지만 이 방식은 안전성 보장과 특히 개발자들의 해석 가능성(interpretability)이 떨어지며, 특히 복잡하고 동적인 실차 도시 환경에서는 한계가 있다.
 
그렇다면 다음과 같은 의문이 자연스레 따른다.

신뢰할 수 있는, 플래닝 중심의 자율주행 시스템을 만들기 위해 파이프라인은 어떻게 구성해야 하는가?
어떤 선행 태스크들이 반드시 필요한가?

 
E2E 자율주행이란 주변 객체를 인식하고, 그들의 미래 행동을 예측한 후, 안전한 주행 경로를 명시적으로 계획하는 것이다 (그림 1(c.2)).
핵심은 세부적인 구성에 있으며 이전 연구들은 플래닝 중심의 구성 요소 일부를 빠뜨리는 경우가 많았다. (위 표의 (c.2) 참조)
특히 planning-oriented 설계 시스템에 관한 연구가 다소 부족하다.
 
UniAD는 자율주행 분야에서 감지, 예측, 플래닝을 모두 공동 학습(co-training)한 첫 번째 포괄적 연구이다.

기여 요약 (Contributions)

  • 플래닝 중심의 철학에 기반한 새로운 자율주행 프레임워크 관점을 제시하고, 독립적 설계나 단순 MTL보다 효과적인 태스크 협업이 필요함을 입증
  • UniAD는 여러 작업을 아우르는 종단형(end-to-end) 시스템이며, query 기반 설계를 통해 모든 모듈을 연결하고, 유연한 표현 및 태스크 간 지식 교환이 가능
  • UniAD를 nuScenes에 적용하였으며, 광범위한 ablation 실험을 통해 기존 최신 성능(SOTA)을 모든 측면에서 능가하는 성과를 입증

2. Methodology
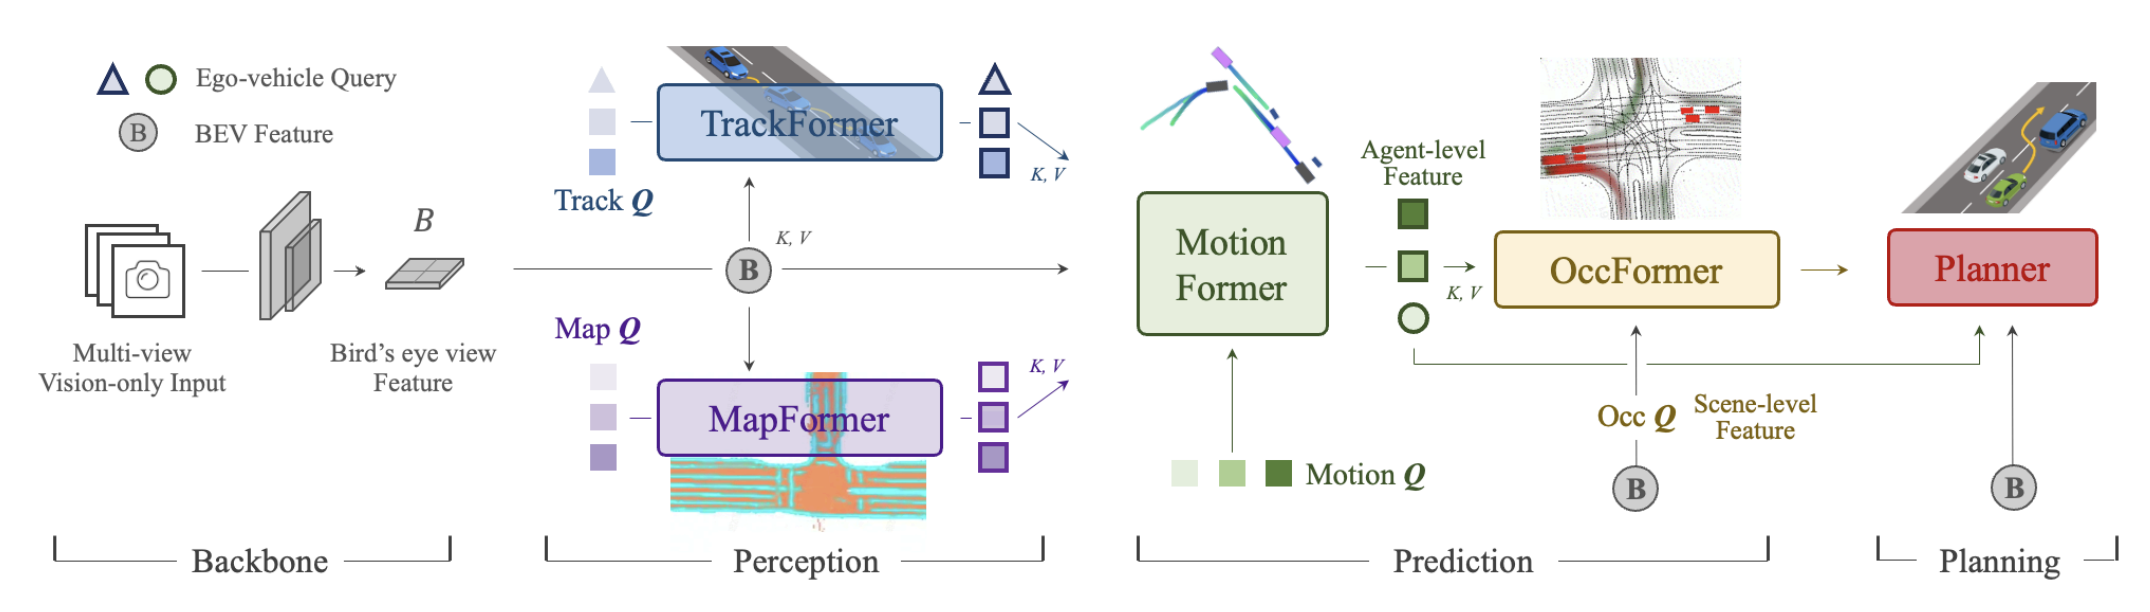
그림 2. UniAD 파이프라인, 플래닝 중심으로 설계된 모습을 볼 수 있으며 각 모듈이 플래닝에 어떤 영향을 주는지 체계적으로 분석 가능하다.

UniAD는 Transformer 디코더 기반으로 구성되어 있으며, BEV Query를 통해 모든 모듈이 연결되어 있다. 이러한 쿼리는 주행 시나리오에서 태스크 간 상호작용을 모델링하는 역할을 한다고 생각하면 된다.

해당 네트워크는 특정 BEV 인코더에 종속되지 않으며, long-term temporal fusion, multi-modal fusion 등을 통해 더 풍부한 BEV 형태로 확장할 수 있다.


**사전 지식 공유

더보기

Planning 관점에선 BEV 형태의 데이터를 활용하였을 때 성능이 좋은 모습을 보였다.

이 때문에 LSS(Lift-Splat-Shoot) 기반의 멀티 카메라 영상을 BEV 위에 투영하고 이를 지속해서 활용하는 형태로 디자인되었다.

트랜스포머 구조를 활용하기 위해선 모든 데이터가 이 BEV 형태로 가공되어야 했으며, 쿼리로 사용되기 때문에 기존 전통적인 Convolution 기반의 네트워크에서 피쳐맵이라고 부르던 데이터를 쿼리라고 명칭한다.


이번 섹션에선 본격적으로 모델의 구성 요소에 대해서 살펴보자.


2.1. Prediction: Tracking and Mapping

TrackFormer

TrackFormer는 학습이 불가능한(미분이 불가능한) 후처리 없이 객체 탐지(OD)와 다중 객체 추적(MOT)를 동시에 수행한다.

기존의 탐지 쿼리에 트랙 쿼리를 도입하였는데, 현재 시점의 track query는 self-attention 모듈에서 이전에 출력했던 BEV 쿼리들과 상호작용하여 Temporal 정보를 퓨전한다. 만약 트래킹하던 에이전트가 일정 시간 이상 등장하지 않으면 소멸시킨다.

또한,  BEV 쿼리에 자차를 표현하기 위하여 하나의 ego-vehicle query를 추가하여 Planning에 활용한다.

MapFormer

2D Panoptic Segmentation 네트워크인 Panoptic SegFormer를 기반으로 설계되었다.

nuScenes에서 제공하는 HD Map을 가공하여 도로 요소 ([차로, 도로 분리대, 횡단보도]-Thing, 주행가능영역-Stuff)을 매핑한 것을 GT로 사용한다.

MapFormer는 N개의 layer를 가지며, 각 출력은 모두 supervised 된다.

마지막 layer에서 업데이트 된 쿼리 $Q^M$만이 MotionFormer로 전달되어 에이전트-맵 상호작용을 위해 사용된다.


2.2. Prediction: Motion Forecasting

저자는 모션 예측에 강점을 보이는 Transformer 구조를 활용하여 MotionFormer를 제안하였다.

TrackFormer와 MapFormer로부터 전달받은 동적 에이전트 쿼리 $Q^A$와 $Q^M$을 활용하여 Scene-centric 방식으로 모든 에이전트의 multi-modal 미래 이동 경로를 예측한다. (k개)

이 방식은 전체 Scene을 각 에이전트의 좌표계로 변환할 필요 없이 단일 forward pass로 다중 에이전트의 궤적을 예측 가능하여 효율적이다.

또한 앞에서 언급한 ego-vehicle query를 함께 활용하여, 자차가 다른 에이전트와의 상호작용을 고려할 수 있도록 한다.


해당 모듈의 출력은 다음과 같이 정의된다.

$$\hat{x}_{i,k} \in \mathbb{R}^{T \times 2}, \quad i =1,\ldots,N_a,  \quad k=1,\ldots ,K$$

여기서:

  • $i$: 에이전트 인덱스
  • $k$: 궤적 모달리티(인덱스)
  • $T$: 예측 시간 길이

MotionFormer 역시 N개의 Layer로 구성되며, 각 계층은 세 가지의 상호작용을 학습한다.

  1. 에이전트-에이전트
  2. 에이전트-지도
  3. 에이전트-목표 지점 (Goal point)

각 모션 쿼리 $Q_{i, k}$ (이하 Q)는 다음과 같이 상호작용을 계산한다:

$$Q_{a/m} = MHCA(MHSA(Q), Q_A/Q_M)$$

**MHCA: Multi-head Cross-Attention / MHSA: Multi-head Self-Attention


또한 정밀한 궤적 예측을 위해 Goal point를 중심으로 deformable attention을 적용한다.

$$Q_{g} = DeformAttn(Q, \hat{x}^{l-1}_T, B)$$

여기서 $\hat{x}^{l-1}_T$는 이전 layer에서 예측된 마지막 지점이다. DeformAttn은 쿼리 q, 레퍼런스 포인트 r, 공간 피쳐 x를 받아 레퍼런스 포인트 주변의 특징에 sparse attention을 수행한다.

세 가지 상호작용 Q_a, Q_m, Q_q는 병렬로 계산되며, 이후 concat된 후 MLP(Multi-Layer Perceptron)을 거쳐 쿼리 context $Q_{ctx}$로 변환된다.

$Q_{ctx}$는 다음 Layer에 전달되며, 만약 마지막 Layer의 출력이라면 예측 결과로 디코딩된다.


Motion Query 정의

각 Layer의 입력 쿼리는 다음 두 요소이다.

  1. 이전 계층의 출력  $Q_{ctx}$
  2. 위치 정보를 포함하는 $Q_{pos}$

여기서 $Q_{pos}$는 다음 네 가지 위치 정보를 통합한다:

$$Q_{pos} = MLP(PE(I^s))+MLP(PE(I^a))+MLP(PE(\hat{x}_0))+MLP(PE(\hat{x}^{l-1}_T$$


여기서 PE는 Transformer에서 자주 등장하는 개념인 sinsoidal Position Encoding이다.

  • $I^s$: Scene-level 앵커
  • $I^a$: Agent-level 앵커
  • $\hat{x}_0$: 에이전트의 현재 위치
  • $\hat{x}^{l-1}_T$: 이전 layer에서의 예측 목표 지점

$I^s, I^a$는 GT 궤적의 endpoint를 k-means로 클러스터링한 앵커이며, 예측 불확실성을 줄이기 위해 활용된다.


Non-linear Optimization

기존 모션 예측은 GT위치와 트랙을 직접 사용할 수 있으나, 이전 모듈(TrackFormer, MapFormer)이 예측한 정보가 잘못됐을 가능성이 있다.

이러한 불완전한 감지 결과에서 GT 궤적을 활용하여 regression을 적용하면 비현실적인 경로 (예를 들어 비현실적인 조향각, 가속 등)가 발생할 수 있다.

이를 해결하기 위해 저자는 비선형 스무딩 기법을 사용하여 시작점이 부정확하더라도 물리적으로 가능한 궤적을 얻을 수 있다.

$$\tilde{x}=\underset{x}{\mathrm{argmin}}\,c(x,\tilde{x})$$

Cost Function:

$$c(x,\tilde{x})=\lambda_{xy}\Vert x-\tilde{x} \Vert_2 + \lambda_{goal}\Vert x_T - \tilde{x}_T \Vert_2 + \sum\limits_{\phi \in \Phi}\phi(x)$$

$\lambda_{xy}$ 및 $\lambda_{goal}$은 각각 하이퍼 파라미터이며, 역학 제약을 반영하기 위한 변수의 집합 $\Phi$에는 다음 다섯 개의 항의 포함된다.

  • jerk (충격도)
  • curvature (곡률)
  • curvature rate (곡률 변화율)
  • acceleration (가속도)
  • lateral acceleration (횡가속도)

이 비용 함수는 예측한 주행 경로가 운동학적 제약(kinematic constraints)을 따르도록 정규화 하는 역할을 한다.

이는 학습에서만 수행되며, 추론 과정에서는 영향을 주지 않는다.


2.3. Prediction: Occupancy Prediction

Occupancy 예측은 Occupancy grid map이란 discretized BEV representation을 예측하는 task다.

**해당 기술을 이해하기 위해선 대표적인 Occupancy network들인 TPVFormer, FB-Occ, OccFormer, FlashOcc 등을 참고하면 좋다. 기존 기술은 3D의 Occupancy map을 활용하였으나 해당 논문에선 연산량의 이유로 2D BEV로 투사된 Occupancy map을 활용하였다.

여기서 Occupancy prediction은 미래 시점에 Occupancy map이 어떻게 변할지를 예측하는 것이다.

기존에는 RNN 구조를 사용해서 시간 축을 따라 예측했지만, 이는 에이전트 구분이 불가하다.

이를 해결하기 위해 저자는 OccFormer(상기 추천한 네트워크와 다름)를 제안하였는데, 이는 scene-level과 agent-level의 의미 정보를 모두 반영한 다음 설계를 따른다.

  • dense scene feature가 미래 시점을 예측할 때, 정교하게 설계된 Attention 모듈이 agent-level Feature를 통합
  • Agent-level Feature와 scene-level Feature 간의 행렬 곱 만으로도간단하게 Instance Occupancy map을 생성할 수 있도록 설계하여 후처리 생략

OccFormer는 $T_O$개의 순차 블록으로 구성되었으며, $T_O$는 예측 시간의 길이를 의미한다.

일반적으로 이는 MotionFormer의 예측 시간 T보다 짧은데, 이는 해상도가 높은 Occupancy map의 연산량이 많기 때문이다.


각 블록은 이전 time-step의 dense Feature($F_{t-1}$)와 Agent Feature($G_t$)를 입력받아 instance-level과 scene-level 정보를 모두 고려한 새로운 Feature $F_t$를 생성한다.

**instance-level이란?

각 객체를 구분하여 식별하고 추적하는 방식. (예를 들어, 1번 사람은 A 위치에 3번 차량은 B 위치에 있음을 식별)


$G_t$는 MotionFormer의 모달리티 차원에서 max-pooling한 motion queary들인 $Q_X \in \mathbb{R}^{N_a \times D}$를 바탕으로 이전 Track query $Q_A$, 위치 임베딩 $P_A$와 함께 시간 연산 전용 MLP를 통해 생성된다.

$$G^t = MLP_t(Concat[Q_A, P_A,Q_X]), \quad t=1,\ldots T_O$$


Scene-level 정보로는 BEV 피처 B를 1/4 해상도로 다운샘플링하여 첫 블록의 입력 $F_0$로 사용하며, 학습 메모리 절감을 위해 각 블록은 다음과 같은 구조를 가진다.

  • 다운샘플링 → Attention → 업샘플링 (즉, 다운샘플링 된 BEV를 추가 다운샘플링하여 1/8 해상도에서 연산)
  • Attention 모듈은 pixel-agent interaction을 수행

Pixel-agent interaction

이는 장면 정보와 에이전트 정보를 통합하여 예측 정확도를 높이기 위한 모듈이다.

  1. Dense Feature $F^t_{ds}$는 self-attention을 통해 먼 거리 간의 관계를 모델링
  2. 이어지는 cross-attention은 에이전트 Feature $G^t$와 grid 상의 픽셀과 상호작용

이 때 cross-attention은 Attention Mask를 활용한 제약 연산을 통해 각 픽셀이 자신이 점유한 에이전트에게만 attention할 수 있도록 한다. 업데이트 과정은 다음과 같다.

$$D^t_{ds}=\mathbf{MHCA}(\mathbf{MHSA}(F^t_{ds}), G^t, attn\_mask = O^t_m)$$

여기서 attention mask $O^t_m$은 점유 확률처럼 동작하며, agent feature를 MLP로 변환한 mask feature $M^t = MLP(G^t)$와 dense feature $F^t_{ds}$ 간의 곱으로 생성된다,

업데이트한 $D^t_{ds}$는 업샘플링되어 다시 1/4 해상도로 복원되며, residual connection으로 입력 $F^{t-1}$과 더해진 후 다음 블록의 입력 $F^t$로 사용된다.

Instance-level Occupancy

각 agent의 정체성을 유지하며 점유를 예측하는 방식이다. 최근 query 기반의 segmentation 연구들처럼 행렬 곱만으로도 간단히 생성 가능하다.

scene-level feature $F^t$는 업샘플링되어 원래의 해상도 $H \times W$로 복원되고:

$$F^t_{dcc} \in \mathbb{R}^{C \times H \times W}$$

agent-level feature는 coarse한 mask featur $M^t$를 occupancy feature $U^t \in \mathbb{R}^{N_a \times C}$로 MLP를 통해 업데이트 한다.

저자는 경험적으로 기존 agent 피처 $G^t$ 대신 mask feature $M^t$로부터 $U^t$를 생성하는 것이 더욱 우수하였다고 언급하였다.

최종 instance-level Occupancy 결과는 다음과 같이 계산할 수 있다:

$$\hat{O}_A^t = U^t \cdot F_{\text{dec}}^t$$


2.4 Planning

자율주행 분야에서 HD Map 없으는 보통 복잡한 경로 계획이 필요하다.

이를 고려하여, 직진, 좌회전, 우회전과 같은 원시적인 네비게이션 신호를 학습 가능하도록 임베딩하여 활용한다. (command embedding)

MotionFormer로부터 전달된 ego-vehicle query는 이미 발생 가능한 다양한 상황에 대한 여러 가능성을 내포하고 있다. 여기에 command embedding을 결합하면 plan query를 형성할 수 있다.

이 plan query는 BEV 피쳐 B에 Attention 기법을 적용하여 주변 상황을 인식하게 하고, 이를 미래 waypoint $\hat{\tau}$로 디코딩한다.

추가로, 충돌을 피하기 위해 추론 시점에는 뉴턴 메서드를 이요한 경로 최적화를 수행한다. 이 과정은 다음과 같은 수식으로 정의된다:

$$\tau^* = \arg\min_\tau f(\tau, \hat{\tau}, \hat{O})$$

  • $\hat{\tau}$: 원래 예측된 계획 경로
  • $\tau^*$: 최적화된 경로 (multiple-shooting 으로 생성된 경로 집합 중 선택)
  • $\hat{O}$: OccFormer에서 생성된 인스턴스 단위 점유 결과를 결합한 binary occupancy map

비용 함수 $f$는 다음과 같이 계산된다:

$$f(\tau, \hat{\tau}, \hat{O}) = \lambda_{\text{coord}} \| \tau - \hat{\tau} \|_2 + \lambda_{\text{obs}} \sum_t \mathcal{D}(\tau_t, \hat{O}^t)$$


여기서 $\mathcal{D}(\tau_t, \hat{O}^t)$는 시점 t에서의 충돌 가능성 cost이다.

$$\mathcal{D}(\tau_t, \hat{O}^t) = \sum_{(x, y) \in \mathcal{S}} \frac{1}{\sigma\sqrt{2\pi}} \exp\left( -\frac{\|\tau_t - (x, y)\|_2^2}{2\sigma^2} \right)$$

  • $\lambda_{coord}, \lambda_{obs}, \sigma$: 하이퍼 파라미터
  • $\tau_t$: 시점 $t$에서의 계획 위치
  • $\mathcal{S} = \{(x, y) \mid \| (x, y) - \tau_t \|_2 < d, \hat{O}^t_{x,y} = 1 \}$: 점유된 영역 내 이웃 픽셀

$\lambda_{coord} \| \tau - \hat{\tau}\|_2$는 $l_2$ loss로 경로가 기존 예측 경로 ($\hat{\tau}$)에서 벗어나지 않도록 하며, $\lambda_{obs} \sum_t \mathcal{D}(\tau_t, \hat{O}^t)$는 주변에 점유된 grid가 있으면, 그로부터 멀어지도록 경로를 조절한다.


2.5. 네트워크 학습

UniAD는 두 단계의 학습 절차로 훈련된다.

  1. Perception 모듈인 TrackFormerMapFormer를 몇 에폭 동안 함께 훈련한다 (실험에서는 6 epochs).
  2. Prediction과 planning 모듈까지 포함하여 전체를 end-to-end 방식으로 20 epoch 학습한다.

이러한 2단계 학습 방식은 경험적으로 더 안정적인 수렴을 가져온다.

또한 UniAD는 instance level 모델링을 포함하므로, perception과 prediction 단계에서 예측값과 GT 사이의 매칭이 필요하다.

**앞에서 instance-level 모델링은 개별 객체들의 위치 등을 나누어 모델링 한 결과라고 설명했다. 즉, 어떤 GT가 어떤 객체의 GT인지를 매칭해줄 필요가 있다. 이를 위한 bipartite matching 기법을 사용하는 것이다.

  • 이는 DETR 스타일의 이분 매칭 알고리즘(bipartite matching)을 기반으로 수행
  • Detection query로부터의 예측된 객체들은 실제로 현재 프레임에서 감지되었어야 할 객체들(GT)과 매칭
  • Track query는 기억하고 있는 연속 매칭 결과를 활용하여 객체를 이어서 추적

이러한 tracking 모듈의 매칭 결과는 이후 motion 및 occupancy 모듈에서도 재사용되어, History Track부터 미래 행동까지 일관된 에이전트 추적을 가능하게 한다.


2.6. Implementation Details

벤치마크 nuScenes
프레임워크 PyTorch (GPU: NVIDIA V100)
입력 영상 카메라 6대, 해상도 1600$\times$900
시퀀스 구성 0.5초 간격, 3초 히스토리 + 6초 예측 (총 12프레임)
BEV 해상도 200$\times$200, grid 크기 $50m$
ㅡOptimizer AdamW (lr = 2e-4, weight decay = 0.01)
Batch Size / Epochs 32 / 20 epochs
사용 GPU 8개, gradient clipping 및 LR decay 적용
추론 시간 (Planning) 약 45ms/frame
추론 시간 (전체) 약 125ms/frame

3. Experiments

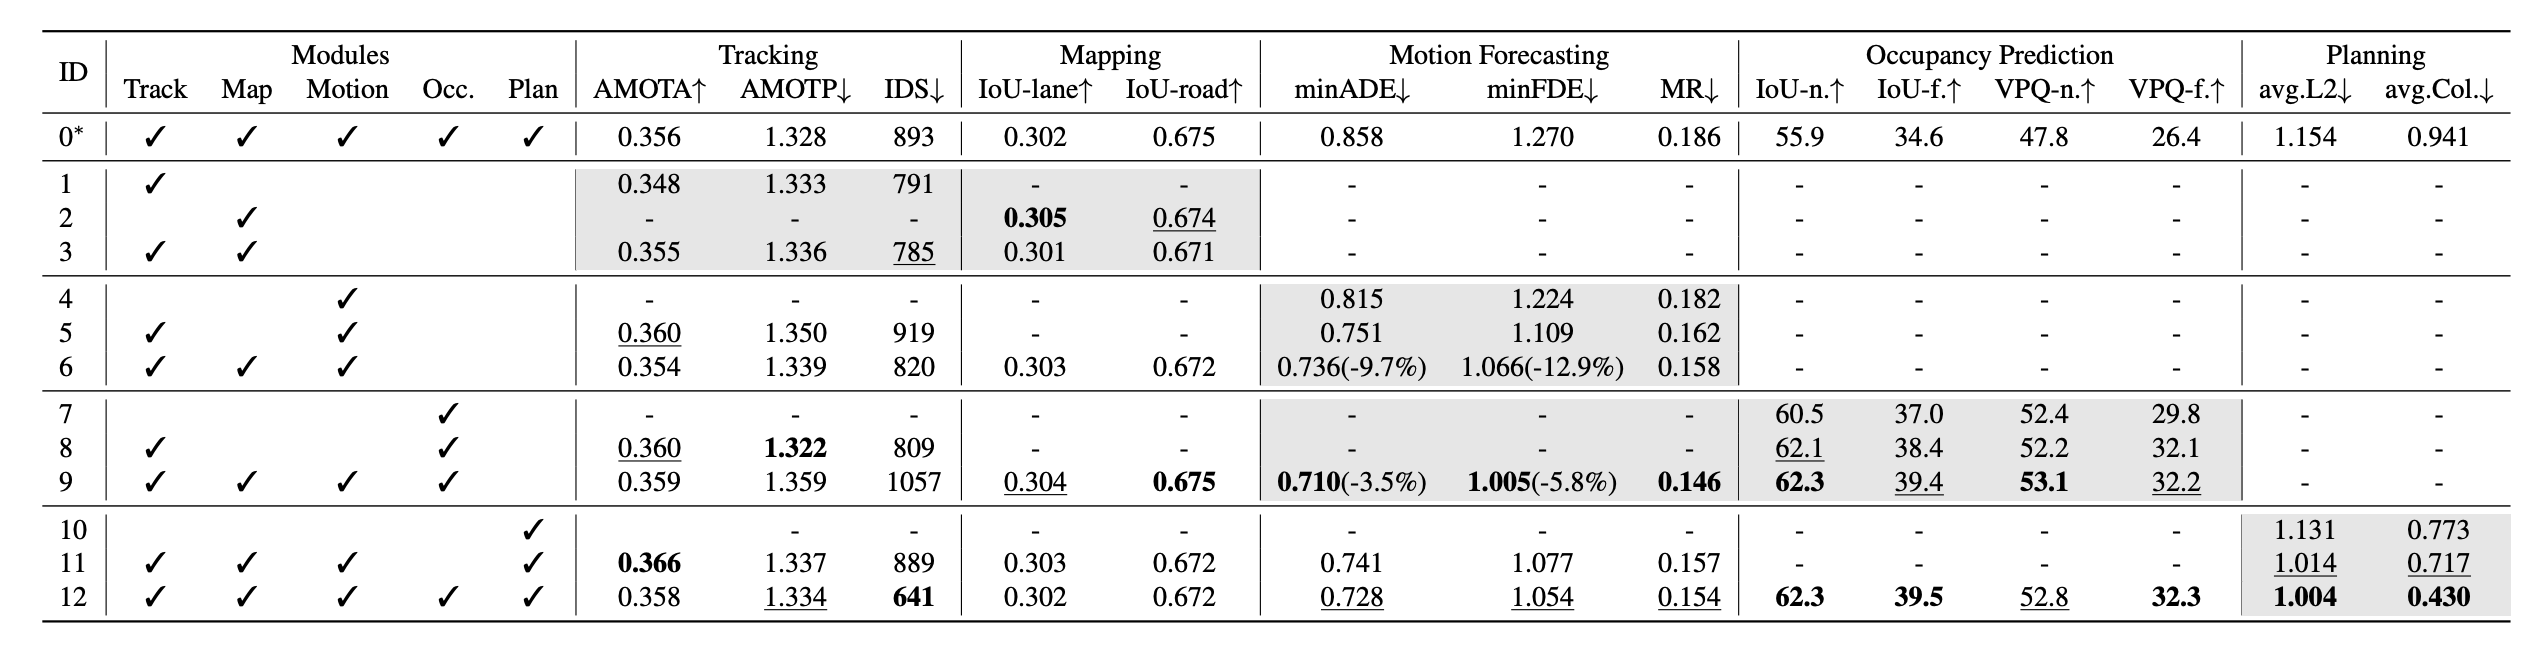
위 표는 UniAD를 구성하는 모든 모듈의 조합에 따른 성능 변화를 나타낸다.

자율주행 E2E의 출력인 Planning은 결국 모든 모듈을 활용하였을 때 가장 높은 성능을 보임을 알 수 있다.

특히 여기서 관찰할 수 있는 세 가지의 중요한 정보는

  1. ID 0(MTL) 방식은 Planning의 L2 에러와 추돌률이 높은 문제를 보이는데 이는 Negative Transfer에 의한 현상이다.
  2. ID 10(Fully E2E) 방식은 L2 loss와 추돌률이 여전히 높은 문제를 보이는데, 이는 중간 모듈의 출력을 확인할 수 없어 최적화가 어렵기 때문이다.
  3. ID 11(non Occ) 방식에서의 Planning 결과는 L2 loss는 충분히 수렴하는 모습을 보였지만, 추돌률은 Occ 포함 버전보다 상당히 높은 모습을 보였다. 결국 Occupancy Prediction은 높은 비용을 희생해서라도 성능을 위해 포함되어야 하지 않을까 하는 생각이다.

자차 상태 정보 활용

기존 연구에서는 자차의 CAN 정보(속도, 가속도, 각속도 등)와 과거 궤적을 사용하면 계획 성능이 향상된다고 보고했다.

UniAD에서도 이러한 개선이 일부 확인되었지만, BEV feature를 활용해 충분히 학습되면 val set에서는 CAN/hist 정보의 추가적 효과가 미미해진다는 사실을 확인하였다.


또한, 일부 연구에서는 자차 정보만으로도 최첨단 성능에 도달할 수 있다고 주장하지만, 실제로 UniAD와 비교했을 때, 복잡한 시나리오나 지도 정합성 평가에서 성능이 급격히 낮아지는 경향이 관찰되었다.

이러한 결과는 closed-loop 검증까지 가지 않더라도 open-loop에서 조차 UniAD의 설계가 유효하다는 것을 확인할 수 있다.


성능 평가 결과

Multi Object Tracking
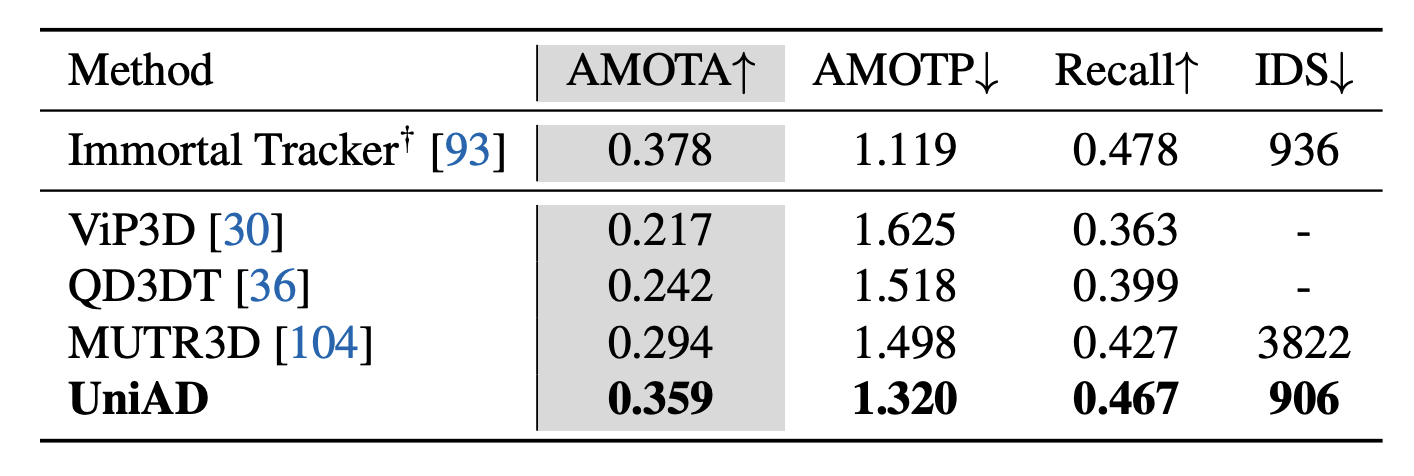
위 표는 UniAD가 Multi Object Tracking(MOT) 분야에서 뛰어난 성능을 보임을 입증한다.

평가에 사용된 지표는 다음과 같다.

AMOTA ↑ 평균 다중 객체 추적 정확도, 다양한 recall 임계값에서의 성능을 통합 측정한 지표.
AMOTP ↓ 평균 추적 정밀도, 추적된 객체들의 위치 정확도를 나타냄.
Recall ↑ 얼마나 많은 GT 객체를 추적에 성공했는지에 대한 비율
IDS ↓ ID Switches: 동일 객체를 다른 ID로 오인한 횟수


Online Mapping

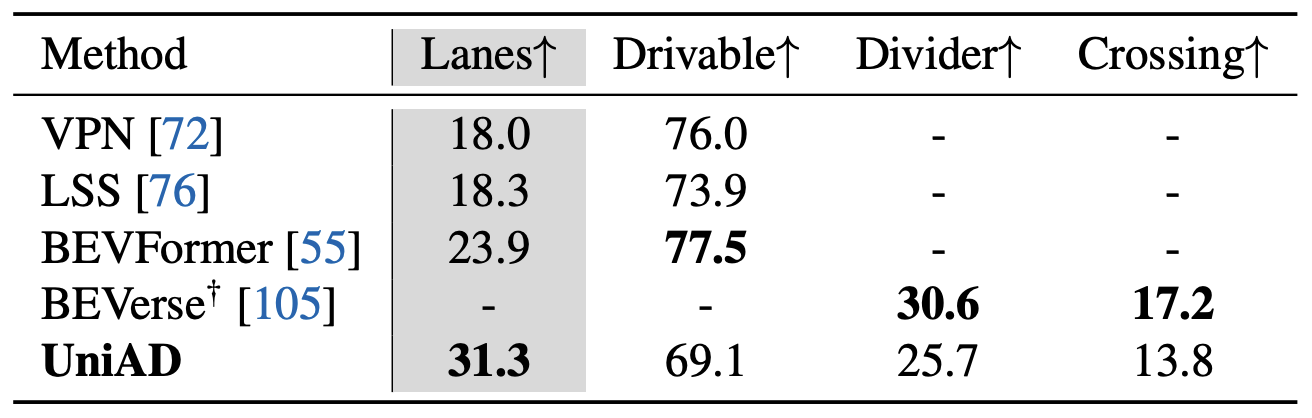
해당 실험은 MapFormer의 Panoptic Segmentation의 결과로 평가되으며, PQ(Panoptic Quality) 수치가 산정되었다.

(GT로 사용된 데이터는 폴리곤 형태로 제공되는 HD Map)

보다시피 UniAD는 Lane 검출에 강점을 보인다. (주행 차선, 우리가 일반적으로 생각하는 Line이 아닌 달리는 경로)

이는 이후 MotionFormer의 에이전트 경로 예측이나 Planner의 충돌 회피, 도로 준수 등에서 신뢰도 높은 차선 정보를 활용 가능함을 나타낸다.


Occupancy Prediction
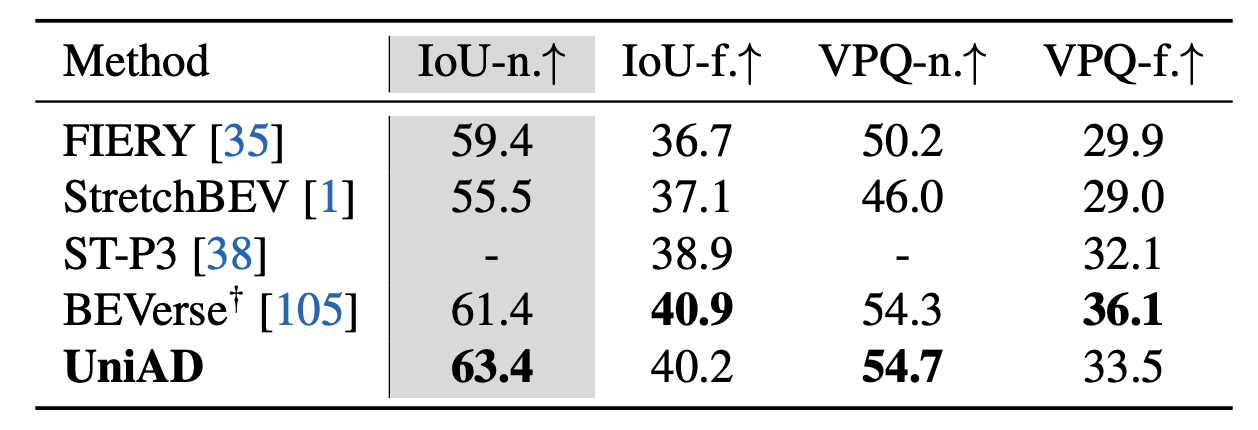
평가에 사용된 지표는 다음과 같다.

IoU-n ↑ 정적인(non-moving) 객체에 대한 Intersection over Union (IoU). 높을수록 정적인 물체를 잘 예측함
IoU-f ↑ 움직이는(moving) 객체에 대한 IoU. 일반적으로 더 어려운 예측 대상
VPQ-n ↑ 정적 객체에 대한 Video Panoptic Quality. IoU + 시간적 일관성까지 평가
VPQ-f ↑ 움직이는 객체에 대한 Video Panoptic Quality. 가장 종합적이고 어려운 지표 중 하나

UniAD는 정적 객체에 대한 성능이 비교 모델 중 제일 높았으며, 움직이는 객체에 대한 성능도 상위권에 위치했다.

전반적으로 Occupancy map 예측에서 매우 안정적이며 정밀한 성능을 보였다.


Planning
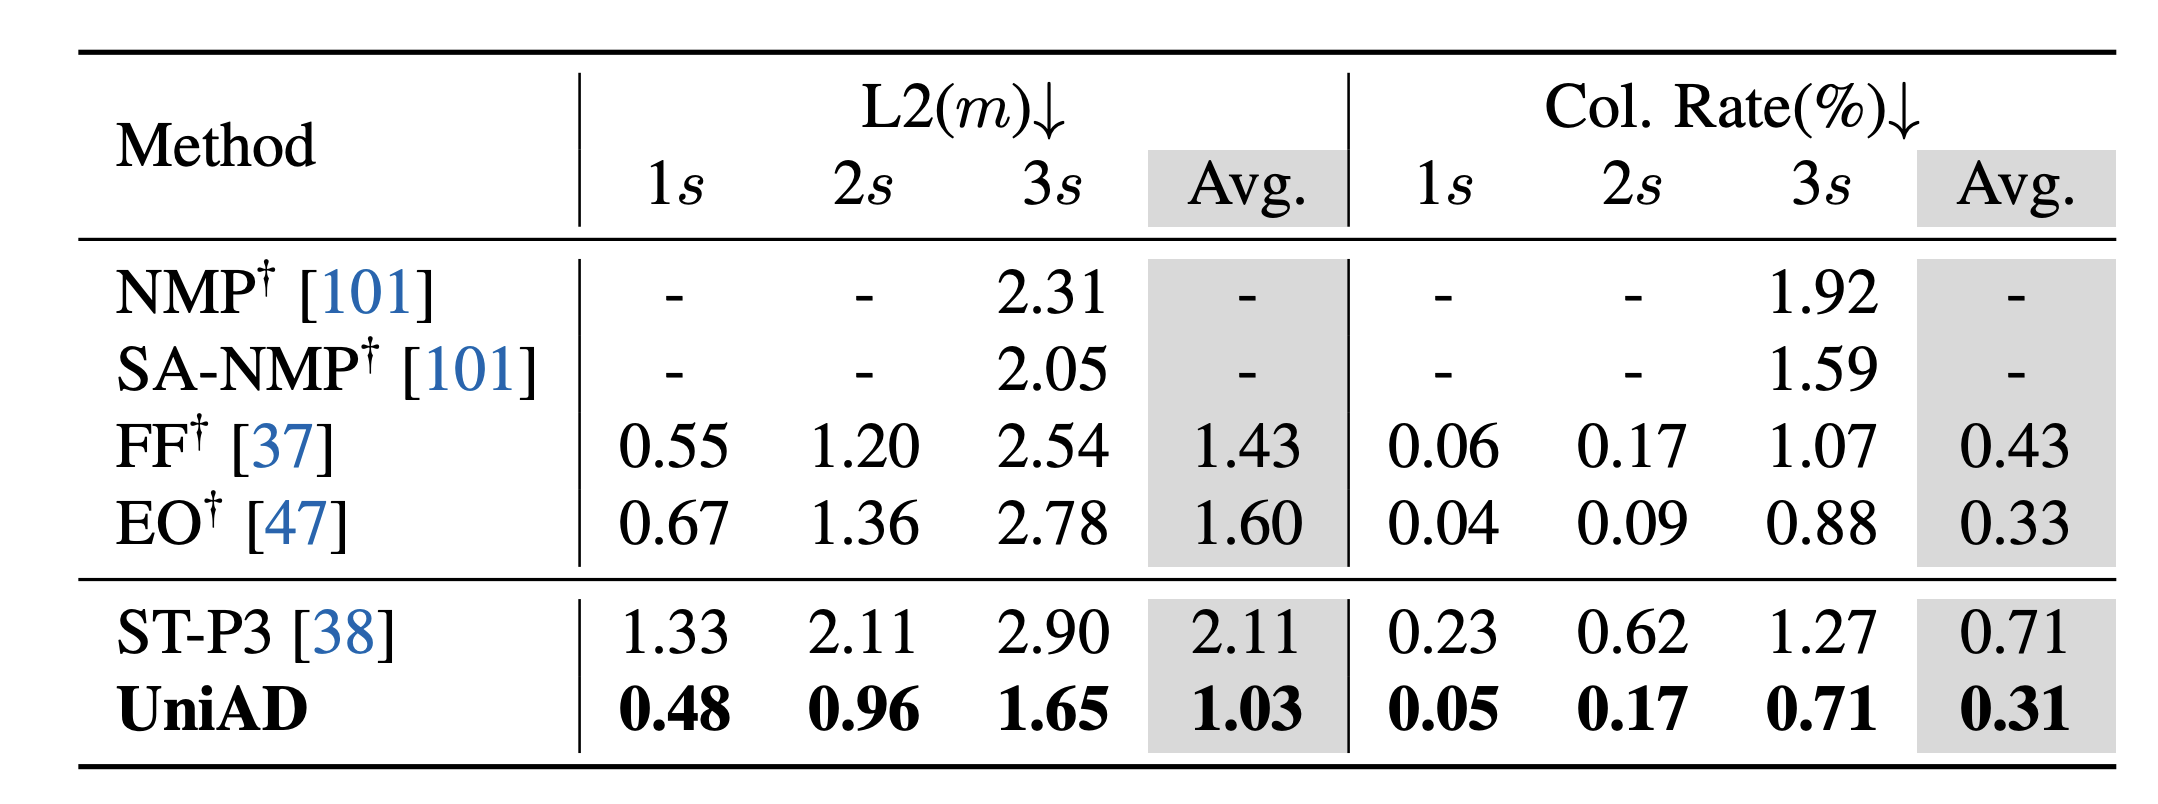
Planning 평가 결과, UniAD는 기존 방식들에 비해 확실히 나은 성능을 보인다.

특히 Para-Drive 논문에서 진행한 E2E 네트워크들의 추돌 평가에서 제일 나은 모습을 보였는데, 이는 Occupance prediction 모듈의 유무에 따른 결과로 보인다.

재밌는 점은 표의 십자가(†) 표식은 LiDAR 베이스의 논문임에도, 카메라만으로 이보다 더 나은 Planning 성능을 보였다는 점이다.

또한 자율주행 E2E(제어 제외) 네트워크의 최종 출력이라고 할 수 있는 Planning에서 좋은 성능을 보인다는 말은 결국 Negative Transer가 발생하지 않았다고 말할 수 있다.
 

0.Abstract

  • 딥러닝 네트워크는 높은 정확도를 위해 큰 연산 비용을 치룬다. 하지만 대다수의 사용자는 높은 정확도는 필요하지만 빠른 동작이 필수적이다.
  • 이에 맞추어 Floating point으로 훈련된 최신 네트워크들을 Fixed point로 양자화하고 그 성능을 유지할 수 있다면 연산 속도가 빨라질 것이다.
  • 제안된 PACT는 activation을 임의의 bit 정밀도로 양자화가 가능하며 일반적인 양자화보다 높은 정확도를 확보할 수 있다.
  • 특히 가중치/활성화를 4bits 정밀도로 양자화할 수 있으며 성능은 Full precision과 유사한 동향을 보였다.

1. Primary Contribution:

  • 최적 양자화 스케일을 찾을 수 있는 새로운 활성화 함수 양자화 기술인 PACT를 제안한다.
    • 새롭게 도입한 α 파라미터는 활성화 함수를 클리핑하는 수준을 결정하기 위해 사용되며, 역전파를 통해 학습된다.
    • α는 양자화 오류를 줄이기 위해 ReLU보다 Scale이 작으며, 경사 흐름을 원활히 만들기 위해 전통적인 클리핑 활성화 함수보단 Scale이 크다.
    • 빠른 수렴을 위해 Loss function에서 α는 정규화된다.
  • Extremely low bit-precision(≤ 2-bits for weights & activation)에서 PACT는 최고의 양자화 모델 정확도를 달성했다.
  • PACT에 의해 양자화된 4-bit CNN은 single-precision floating point 모델과 비슷한 정확도를 달성하였다.
  • 다양한 bits 표현에 따른 하드웨어 복잡도와 모델의 정확도의 Trade-off 관계를 입증하고 분석한다. 또한, PACT의 컴퓨터 엔진 관점에서의 엄청난 효과를 보일 수 있음을 보이고 시스템 레벨에서의 성능 향상을 확인한다.

2.Challenges in Activation Quantization

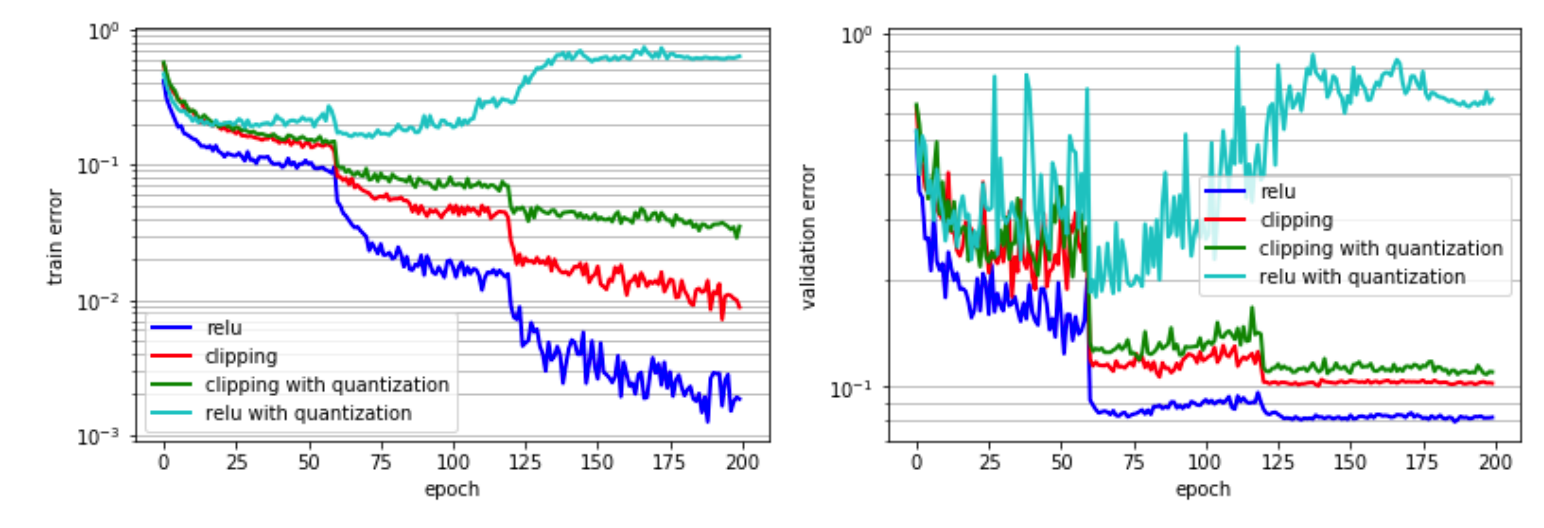
< Fig 1 > (a) 훈련 오류, (b) CIFAR10 데이터셋을 사용하는 ResNet20 모델에 대한 양자화/일반 ReLU/Clipping 모델 Validation error


  • 가중치 양자화는 가중치과 관련된 Loss function의 가설 공간을 이산화(discretizing)하는 것과 같다. 따라서 모델 훈련 중에 가중치 양자화 오류를 보상하는 것이 가능하다!
  • 애석하게도 과거에 사용하던 활성화 함수는 훈련 가능한 파라미터를 가지고 있지 않았기 때문에 활성화를 양자화하면서 증가하는 에러를 역전파로 즉시 보상할 수 없었다.
  • 이와 달리 ReLU는 활성화 기울기를 파라미터로 전파하여 다른 활성화 함수에 비해 우수한 정확도를 달성하기 때문에 훈련할 파라미터를 보유하고 있다. 하지만 ReLU의 출력은 (0,∞)이므로 ReLU 이후의 양자화를 위해선 엄청난 동적 범위(ex. more bit-precision)가 요구됐다. 그림을 봐도 양자화된 relu의 성능이 매우 떨어짐을 확인할 수 있다.
  • 이러한 동적 범위(High dynamic range) 문제는 threshold(upper bound)를 주는 방식인 clipping을 사용하여 어느정도 해결 가능하다. 하지만 레이어 마다, 모델마다 최적의 전역 Clipping 값을 결정하기 매우 어렵다. 그림을 확인해보면 clipping을 함께 활용했을 때 relu에 양자화를 적용했을 때보단 오류가 줄었지만 아직도 baseline 보단 오류가 큰 것을 확인할 수 있다.

3.PACT: Parameterized Clipping Activation Function

  • PACT에서는 Clipping level을 설정하는 α가 존재한다. α는 양자화로 인해 발생한 정확도 감쇠를 줄이기 위한 목적으로 역전파를 통해 훈련 간에 동적으로 교정된다.
  • 기존 사용하던 ReLU는 다음과 같은 함수로 교체된다:

$$y = PACT(x) = 0.5(|x| - |x - \alpha| + \alpha) = \begin{cases} 0, & \mbox{} x\in(-\infty,0)\\ x, & \mbox{} x\in[0,\alpha)\\ \alpha, & \mbox{} x\in[\alpha, +\infty) \ \end{cases}$$


  • α는 활성화 함수의 범위를 제한하는 역할을 수행하며, 잘린 활성화 출력은 다음 수식으로 dot-product를 위해 k bits로 선형 양자화된다.

$$y_q = round(y\cdot \frac {2^k-1}{\alpha}) \cdot \frac {\alpha}{2^k -1}$$

  • 위의 활성화 함수를 활용하면 α Loss functino의 변수이며 훈련 중에 값을 최적화할 수 있다. 역전파의 경우 ∂yq/∂α는 STE(Straight-Through Estimator)를 활용하여 계산되며 ∂yq/∂y를 1로 추정할 수 있다.

$$\frac{\partial y_q}{\partial\alpha} = \frac{\partial y_q}{\partial y}\frac{\partial y}{\partial\alpha} = \begin{cases} 0, & \mbox{} x \in (-\infty, \alpha) \\ 1, & \mbox{} x \in [\alpha, +\infty) \end{cases}$$

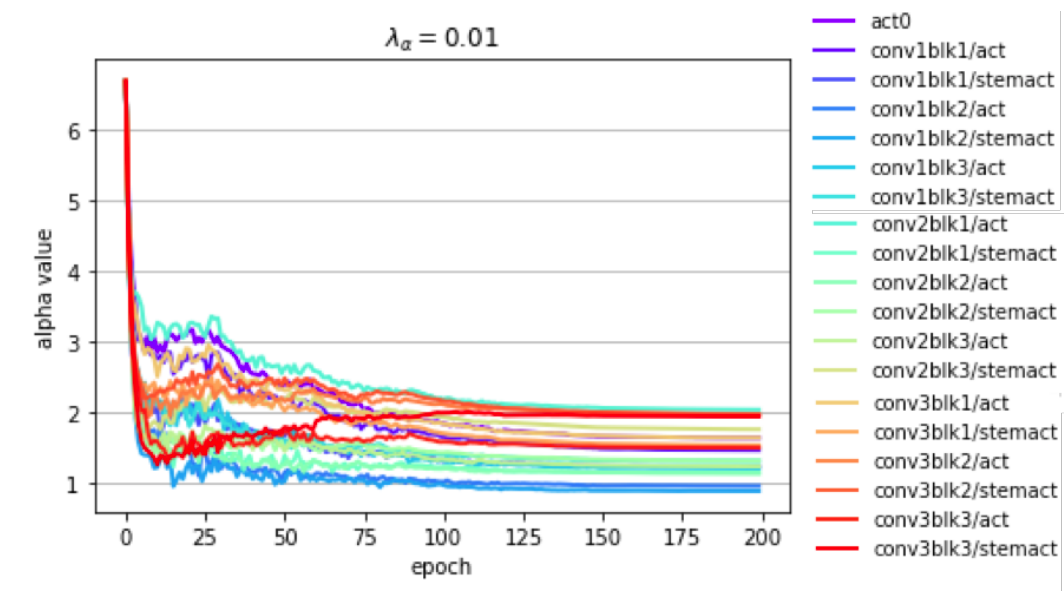
  • α가 클수록 매개변수화 된 Clipping 함수가 ReLU와 비슷해진다. 넓은 동적 범위로 인한 큰 양자화 오류를 방지하기 위해여 α에 대해 L2-정규화를 적용한다. Fig2는 완전 정밀 훈련 간 초기값 10에서 시작했을 때 L2-정규화를 적용하면 α 값이 어떻게 변하는지 보여준다. 훈련 apoch에 따라 α가 훨씬 작은 값으로 수렴하여 활성화의 범위를 제한하고 손실을 최소화하는 것을 확인할 수 있다.

< Fig 2 >  CIFAR10 데이터셋+ResNet20을 사용한 훈련 중 α 값의 변화.

3.1. Understanding How Parameterized Clipping Works

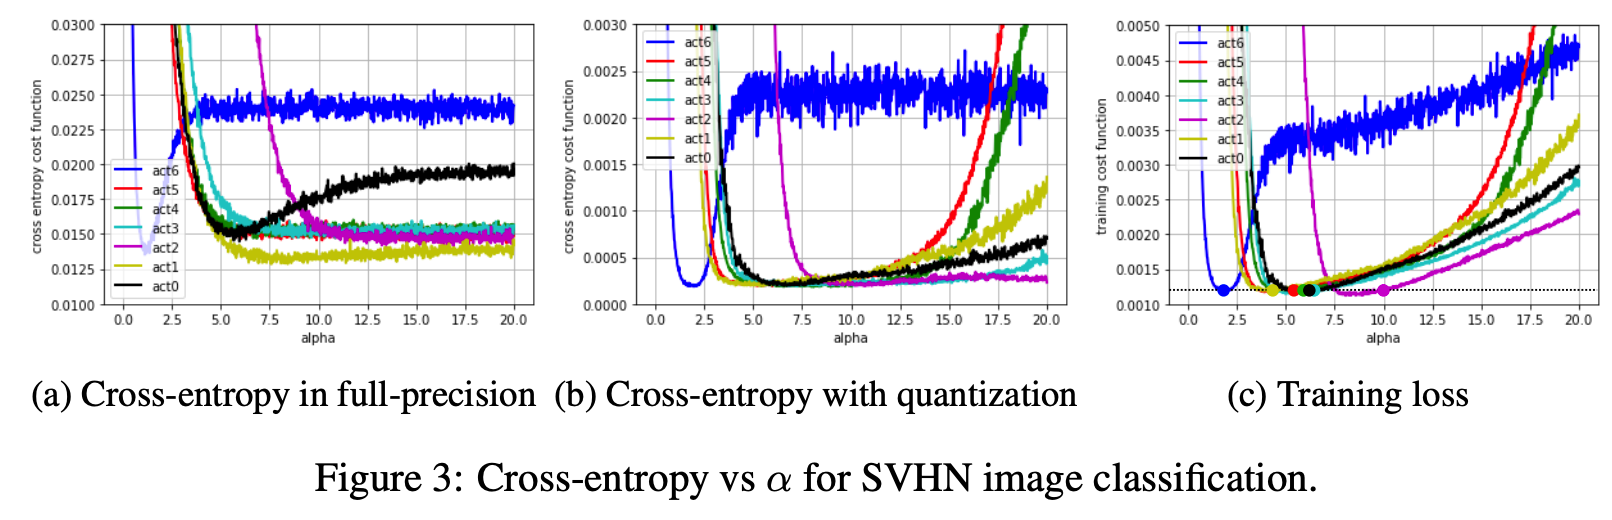
  • Fig.3은 사전 훈련된 SVHN 네트워크에서 α 범위에 대한 교체 엔트로피 및 훈련 소실을 보여준다.
  • 모델에서 7개의 각 conv 레이어에 대한 활성화 함수 ReLU가 제안된 clipping ActFN으로 대체된 제안된 양자화 방식으로 훈련된다. 교차 엔트로피를 계산할 때는 현 레이어의 α를 제외한 모든 파라미터를 고정한 상태로 한 번에 한 레이어씩 α 값을 수정한다.
  • 양자화 없이 계산된 교차 엔트로피는 Fig 3. (a)에 나와있다. 이는 α=∞와 같고, 교차 엔트로피는 α가 증가함에 따라 많은 레이어에서 작은 값으로 수렴된다는 사실을 확인할 수 있다. (ReLU는 좋은 활성화 함수임을 다시한 번 확인할 수 있다)
  • 그러나 α를 훈련하면 특정 레이어에 대한 교차 엔트로피를 줄일 수 있을 것 역시 예상할 수 있다. act0과 act6의 그래프를 보면 튀는 모습을 보이기 때문이다.
  • 다음으로 양자화 된 교차 엔트로피는 Fig3. (b)에 나와있다. 양자화를 사용하면 대부분 α가 증가함에 따라 교차 엔트로피가 증가하여 ReLU의 성능이 떨어짐을 볼 수 있다. 또한 최적의 α가 레이어마다 다른 것을 관찰할 수 있는데, 훈련을 통해 양자화 Scale을 학습한다면 해당 문제를 해결할 수 있을 것이다. 또한, 특정 범위에 대해 교차 엔트로피가 높은 엔트로피에 수렴(act6)하는 것을 확인할 수 있는데, 이는 경사하강법 기반 훈련에 문제를 일으킬 수 있다.
  • 마지막으로, Fig 3. (c)에서는 교차 엔트로피와 α 정규화 학습을 모두 사용한 총 훈련 손실을 보여준다. 정규화는 훈련 손실의 안정화 수렴을 효과적으로 제거하여 경사하강법 기반 훈련에 효과적인 수렴을 일으킨다. 동시에 α 정규화는 전역 최소점을 확실하게 한다. 그림을 보면 훈련 손실 커브상의 최적 α 값에 점을 확인할 수 있다.

3.2. Exploration of Hyper-Prarmeters

3.2.1. Scope of α

저자는 총 세 가지 케이스를 비교하였다.

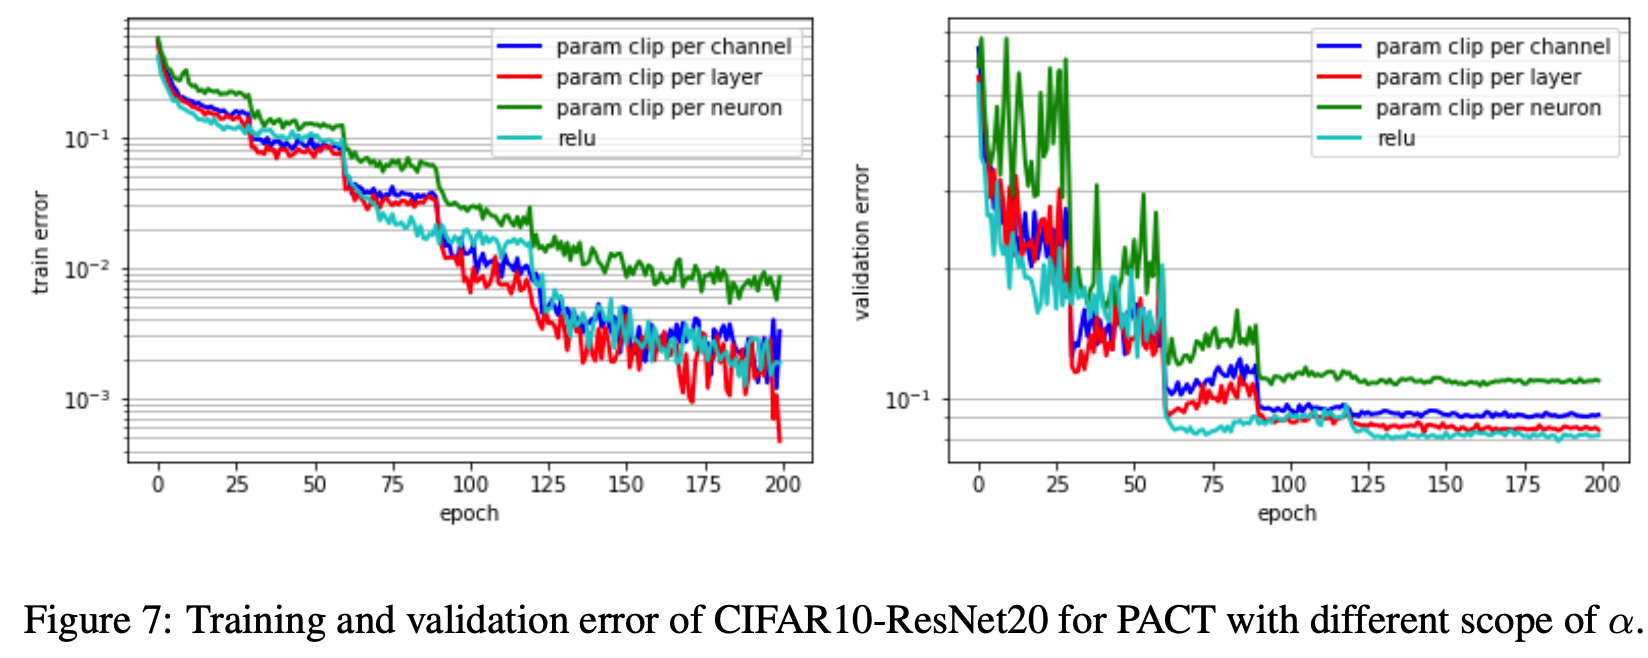
  1. 뉴런 활성화 별 개별적인 α 값
  2. 같은 출력 채널을 가지는 뉴런 사이에서 공유되는 α값
  3. 레이어에서 공유되는 α값

CIFAR10+ResNet20으로 실험한 결과 세 번째 케이스가 가장 높은 성능을 보였다. 이는 하드웨어 복잡도 측면에서도 레이어에서 Multiply-accumulate(MAC) 연산 이후 α가 한 번만 곱해지므로 더 좋은 결과를 보인다.

3.2.2. Initial Value and Regularization of α

  • α가 매우 작은 값으로 초기화되면 더 많은 활성화가 0이 아닌 기울기 범위에 들어가, 훈련 초기에 불안정한 α값을 만들 가능성이 있고 정확도를 하락시킬 수 있다.
  • 그렇다로 α가 매우 큰 값으로 초기화되면 기울기가 너무 작아지고 α가 큰 값으로 고정되어 잠재적으로 양자화 오류가 더 커질 수 있다.
  • 따라서 넓은 동적 범위를 가지고 불안정한 α값을 피하기 위하여 적당히 큰 값으로 α를 초기화하고, 양자화 오류를 완화하기 위하여 α값을 정규화하는 작업이 필요하다.
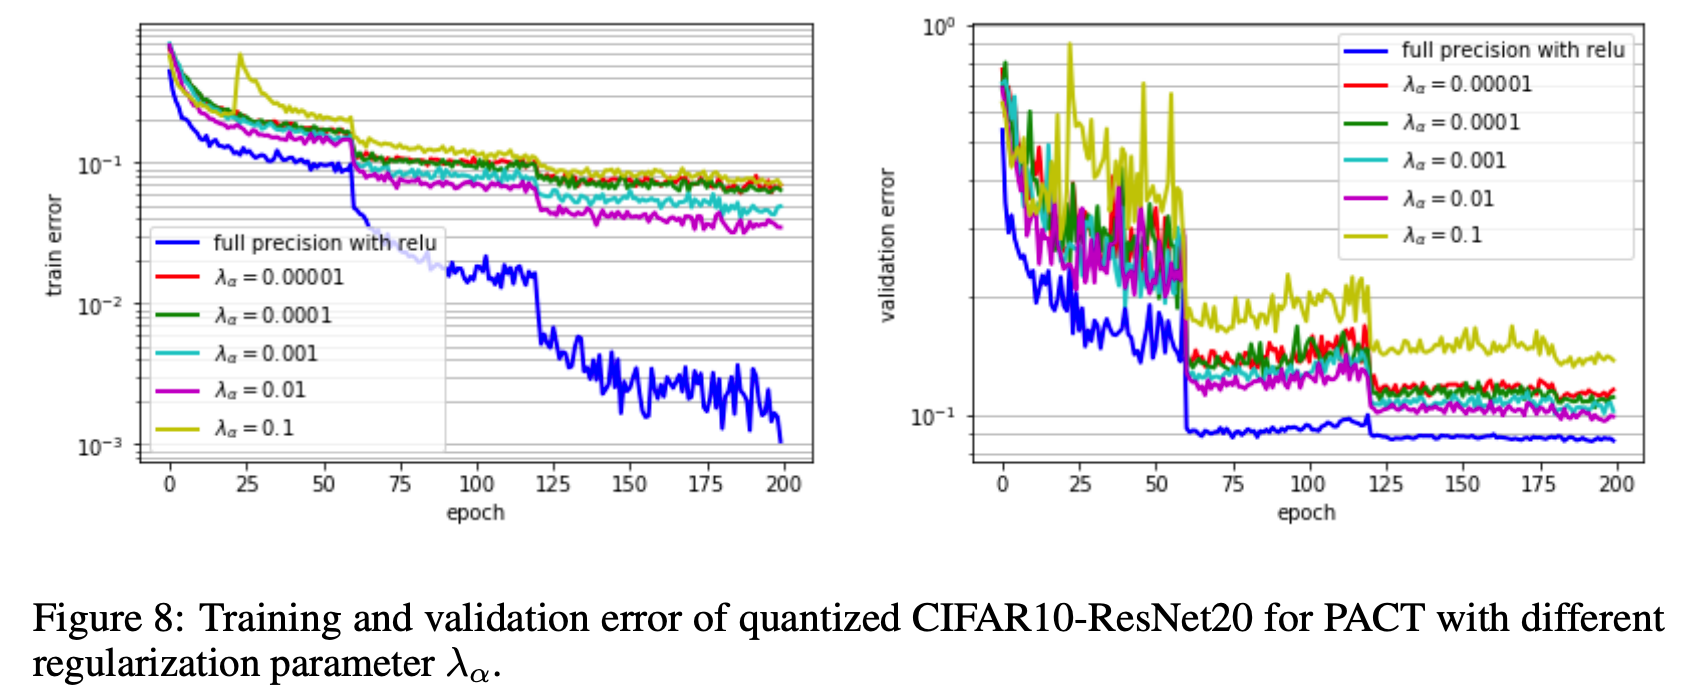
  • 실제로 α에 대해 L2-정규화를 적용할 때 계수 가중치를 α에도 동일하게 적용할 수 있다. Fig. 8을 보면 PACT 양자화 검증 오류가 넓은 범위의 가중치(λ) 값에 대해 크게 별화지 않는 것을 확인할 수 있다.

4. Experiment

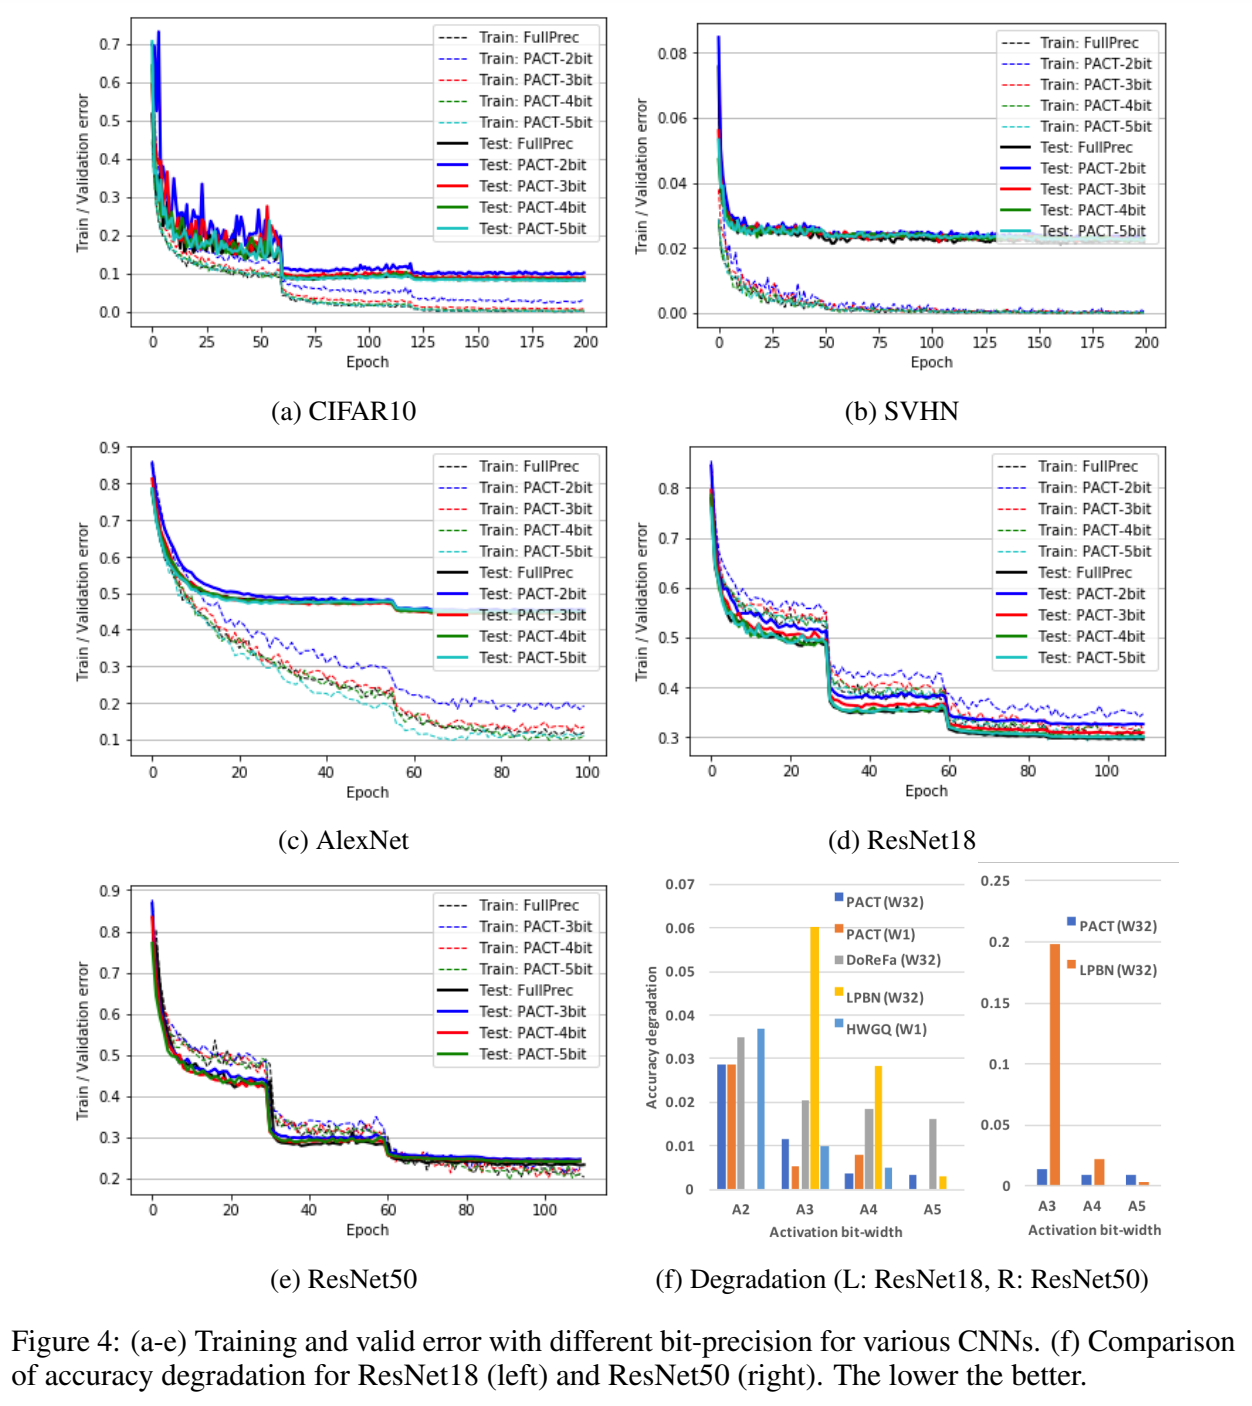
  • 그림을 보면 training/validation error가 full-precision과 비슷하다는 것을 확인할 수 있다.

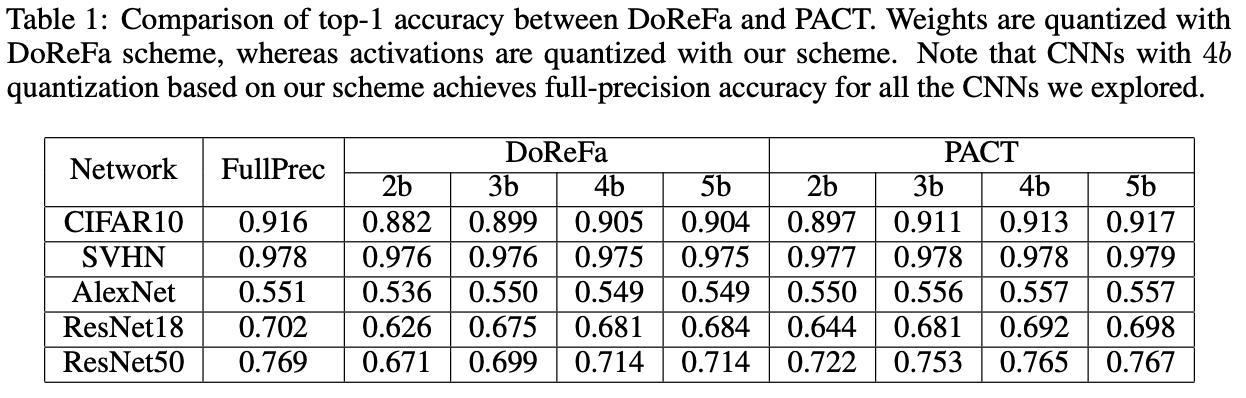
  • 또한, 표에서 볼 수 있듯이 DoReFa와 비교했을 때 더 높은 성능을 보였으며, 4bits 양자화를 PACT로 수행했을 때, full-precision과 성능이 비슷하거나 심지어 더 좋게 나온 케이스도 존재했다.
  • 중요한 것은 가장 낮은 bit 정확도에서도 full-precision 대비 1% 이하의 성능 하락만이 발생했다는 점이다. 

KNN Clustering

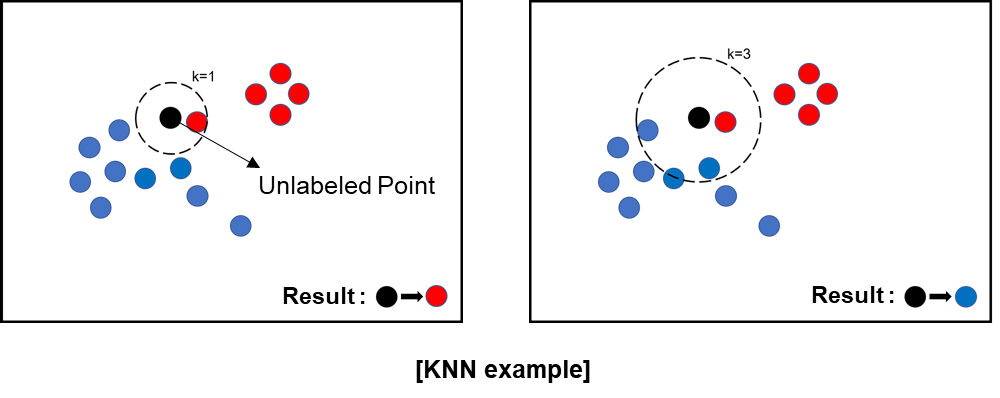
KNN 알고리즘은 k nearest neighbor의 준말으로서, 라벨링 된 k개의 데이터를 참고하여 클래스를 판별하는 알고리즘이다. 작동 방법이 매우 간단하며 구현하기 쉽다.

작동 방식

  1. 우선 k 값을 설정해야 하는데, 보통 데이터의 수의 square root 값을 k로 설정한다.
  2. unlabeled data의 주변 k개의 데이터를 탐색한다.
  3. 과반수를 차지하는 데이터로 현재 데이터를 라벨링한다.

위의 예시를 보면 k값을 어떻게 설정하느냐에 따라서 데이터의 클래스가 달라지는 것을 확인할 수 있다.


RangeNet++에서는 down-sampling된 포인트 클라우드를 Up-scaling하는 과정에서, 부족한 클래스 데이터를 보완하기 위해서 Up-scaling된 출력에 기존 입력 데이터를 중첩하여 KNN 알고리즘을 적용하였다.

Bunch-of-Keys Network 논문 연구를 수행하기 위해서 GIoU와 CIoU를 활용할 필요가 있었다. 아래 연구를 위해 작성한 Matlab 코드를 첨부한다.


Generalized IoU

function [giou,iou] = gIoU(bboxes1, bboxes2)
    
    % Reference : Generalized Intersection over Union: A Metric and A Loss for Bounding Box Regression
    % Calculate generalized Intersection over Union
    
    % define point of first bounding boxes.
    x1p = bboxes1(:,1);
    x2p = bboxes1(:,1) + bboxes1(:,3);
    y1p = bboxes1(:,2);
    y2p = bboxes1(:,2) + bboxes1(:,4);
    
    % define point of second bounding boxes.
    x1g = bboxes2(:,1);
    x2g = bboxes2(:,1) + bboxes2(:,3);
    y1g = bboxes2(:,2);
    y2g = bboxes2(:,2) + bboxes2(:,4);
    
    % Calculate Area of Bboxes1&2
    area_1 = (x2p - x1p) .* (y2p - y1p);
    area_2 = (x2g - x1g) .* (y2g - y1g);
    
    %cal intersection
    IoU_min = bboxOverlapRatio(bboxes1,bboxes2, 'Min');
    Overlap = IoU_min .* min(area_1, area_2');
    All_Area = (max(x2p, x2g') - min(x1p,x1g')).*(max(y2p,y2g') - min(y1p,y1g'));
    C_boxes = (All_Area - (area_1+area_2'-Overlap))./All_Area;
    
    iou = bboxOverlapRatio(bboxes1, bboxes2);
    giou = iou - C_boxes;
end

DIoU & CIoU

function [diou, ciou] = CIoU(bboxes1, bboxes2)
	% Reference :  Distance-IoU Loss Fater and Better Learning for Bounding Box Regression
    % define point of first bounding boxes.
    x1p = bboxes1(:,1);
    y1p = bboxes1(:,2);
    
    % define point of second bounding boxes.
    x1g = bboxes2(:,1);
    y1g = bboxes2(:,2);

    bboxes1_cent = [x1p+bboxes1(:,3)/2 y1p+bboxes1(:,4)/2];
    bboxes2_cent = [x1g+bboxes2(:,3)/2 y1g+bboxes2(:,4)/2];
    cent_dist = pdist2(bboxes1_cent, bboxes2_cent, 'squaredeuclidean');   
    C = (max(x1p+bboxes1(:,3), (x1g+bboxes2(:,3))') - min(x1p,x1g')).^2 +(max(y1p+bboxes1(:,4),(y1g+bboxes2(:,4))') - min(y1p,y1g')).^2;
    R_DIoU = (cent_dist.^2)./C;
    eps = 4/(pi().^2) .* ((atan(bboxes1(:,3)./bboxes1(:,4)) - (atan(bboxes2(:,3)./bboxes2(:,4)))').^2);
    IoU = bboxOverlapRatio(bboxes1,bboxes2);
    alpha = eps./(1-IoU+eps);
    R_CIoU = R_DIoU + alpha .* eps;
    diou = IoU - R_DIoU;
    ciou = IoU - R_CIoU;
end


Demosaicing(디모자이킹)

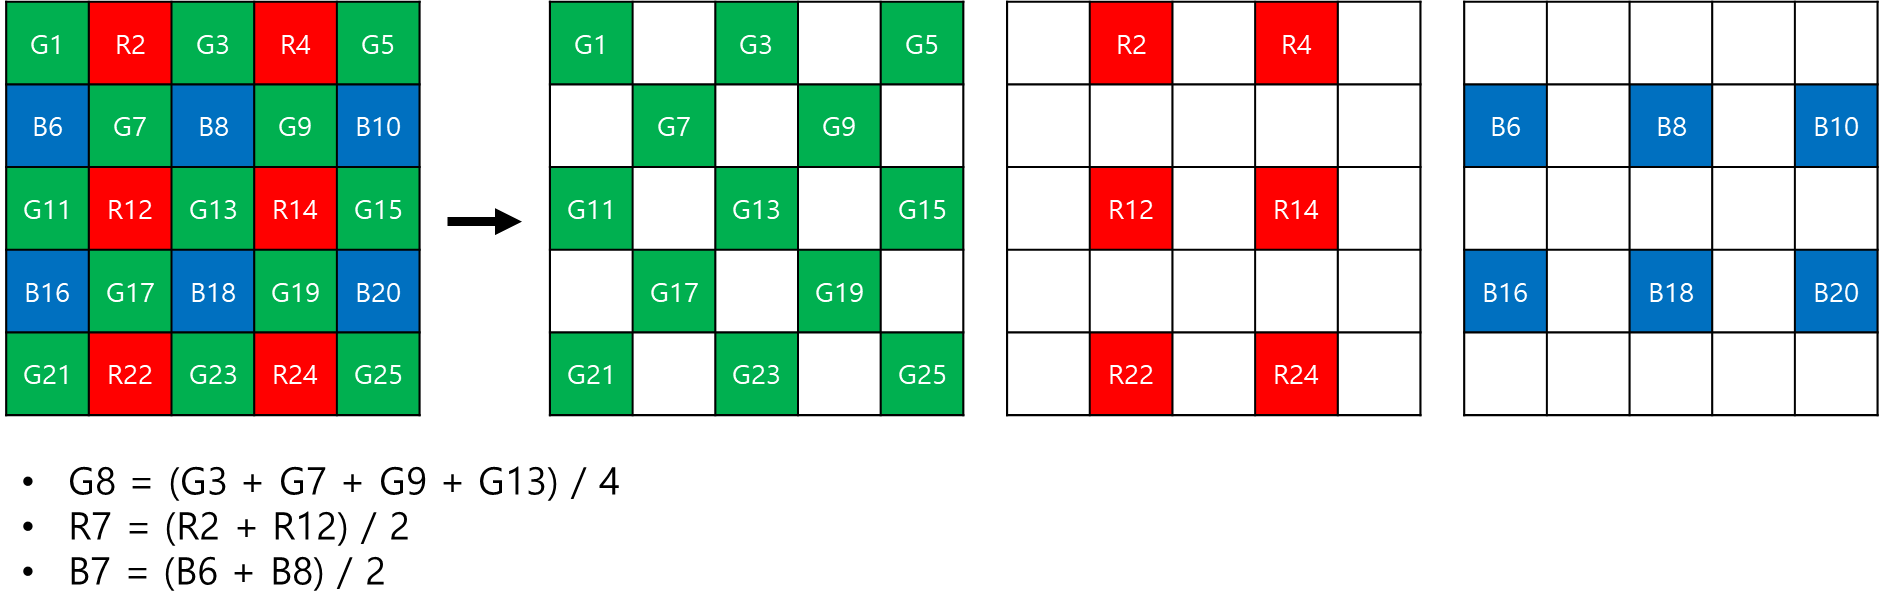
Demosaicing은 color filter array(CFA) interpolation이라고도 한다. 대부분의 이미지 센서는 각 픽셀에서 R, G, B 중 한 가지 색만을 감지한다. 하지만 우리가 보는 실제 영상은 각 화소마다 RGB 값을 모두 갖고있다. 이를 가능케하는 기법이 디모자이킹 기법이다.


Artifacts

일반적으로 디모자이킹 이후에는 edge 영역에서 artifacts가 발생한다. 발생하는 대표적인 artifacts 종류는 다음과 같다.

  • Zipper effect

  • False color

  • Aliasing

  • Blurring


보간 알고리즘

Non-adaptive interpolation

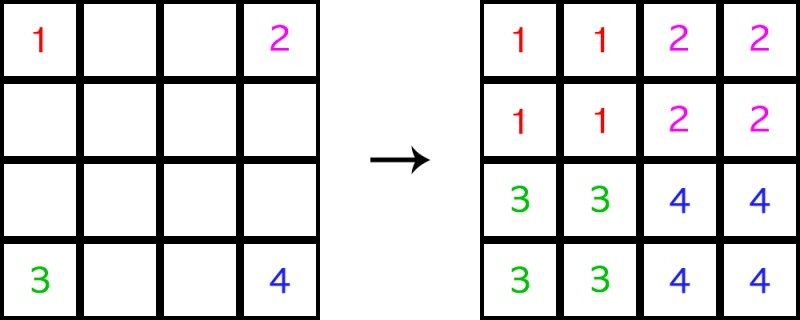
  1. Nearest Neighbor Interpolation : 단순히 가까이에 있는 화소를 출력하는 방식. 가장 간단한 방식이기 때문에 매우 빠르지만, 영상 왜곡이 발생할 가능성이 매우 높다. 보통 Up-scaling에 많이 사용한다.
  2. Bilinear Interpolation : 새롭게 만들어지는 R, G, B 성분은 주변의 가장 가까운 화소들에 가중치를 곱한 값으로 할당된다. 가중치는 선형적으로 결정되며 각각의 가중치는 존재하는 화소로부터의 거리에 정비례한다. 계산 과정이 단순하며 고속으로 처리가 가능하며 Nearest Neighbor 보간보단 나은 영상을 얻을 수 있다. 하지만 Blurring이 발생한다.

Edge-directed Interpolation

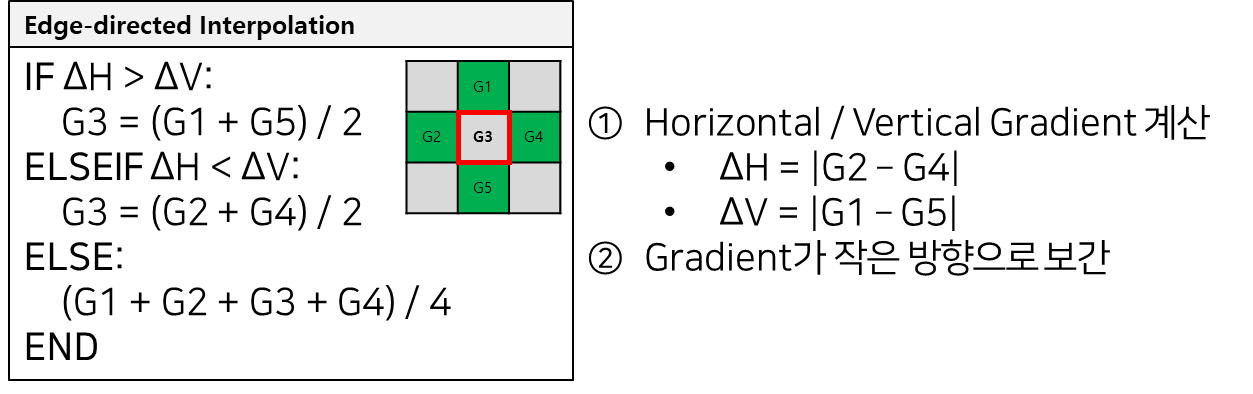
G value를 보간할 때, Horizontal / Vertical 방향으로 밝기 변화를 구해서 변화 값이 작은 쪽으로 보간하는 방식. Non-adaptive interpolation보단 Edge 영역에 효과적이나 여전히 color artifacts는 발생한다. 활용하는 커널의 사이즈가 클수록 좀 더 좋은 영상을 얻을 수 있는 대신 연산량이 증가한다. R, B value는 R/G, B/G에 대한 값을 보간된 G value에 곱하여 보간한다.


Reference

라온피플 블로그 (https://blog.naver.com/PostList.naver?blogId=laonple)

'영상처리 > 이론' 카테고리의 다른 글

[영상처리 ISP] 이미지 센서  (0) 2021.12.06

삼성전자 S.LSI 사업부 면접을 준비하면서 연구 분야의 확장이라고 할 수 있는 이미지의 취득 과정, 각종 전후처리 알고리즘들을 공부할 기회가 있었다. 다양한 블로그에 정리된 자료를 참고하여 공부한 내용을 정리한다.


이미지 센서

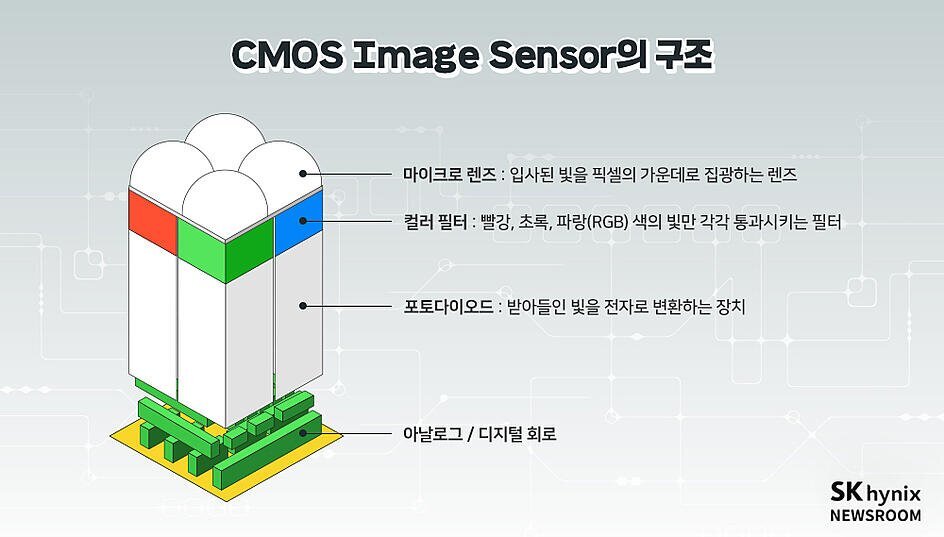
이미지 센서들은 물체에 반사된 빛 에너지를 전기적 영상 신호로 변환해주는 역할을 수행한다. 우리는 디스플레이로 영상 신호를 변환하여 취득된 이미지를 확인할 수 있다. 이미지 센서는 대표적으로 CMOS 센서와 CCD 센서로 분류된다.

① CMOS 이미지 센서

센서는 픽셀들로 구성되어 있으며, 각 픽셀은 1개의 포토 다이오드와  4개의 트랜지스터로 구성되어 있다.

  1. 작동 과정
    • 빛 에너지 중 가시광선 파장대를 실리콘 표면의 포토 다이오드에 집광한다.
    • 실리콘 표면은 빛 에너지를 받으면 공유 결합이 끊어져, 전자와 정공 쌍(Pair)을 형성한다.
    • 생성된 전자와 정공쌍의 전압은 A/D 컨버터를 거쳐 디지털화 된다.
  2. 고화질 영상을 위한 기술
    • 집광된 빛을 디지털화 할 때 활용하는 A/D 컨버터의 성능을 개선하는 기술
    • High amplified gain 기술 및 각종 신호처리 기술
  3. 픽셀 내부에 증폭을 위한 앰프가 내장되어 있다.
  4. 포토 다이오드에서 발생한 전기 신호를 증폭하여 꺼낼 수 있으므로 신호 전송 노이즈의 혼입을 억제할 수 있다.
  5. 반도체와 같은 구조를 띄기 때문에 노이즈 제거 회로, A/D 컨버터 등의 회로를 센서에 탑재가 가능하다.
  6. 읽기와 다채널화, 부분 읽기가 가능하기 때문에 고속 연사가 쉽고 소비 전력이 낮다.
  7. 화소 내에 회로 부분이 필요하기 때문에 포토 다이오드의 크기가 작아져, CCD 센서보다 감도가 떨어진다.

② CCD 이미지 센서

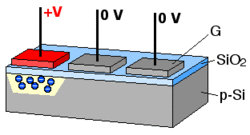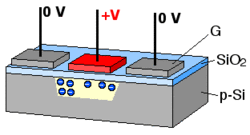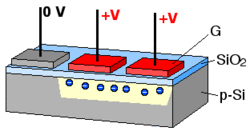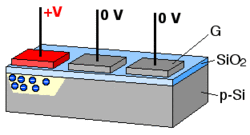
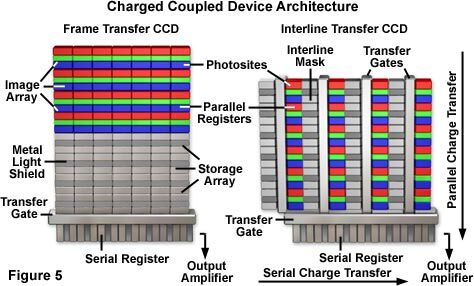
  1. CCD 이미지 센서는 빛에 의해 발생한 전하를 그대로 전송한다.
  2. 전송된 전하들은 수직 전송로를 통해 이동하며, 이후 수평 전송로를 통해 전송되어 순차적으로 증폭된다.
  3. 이후 A/D 컨버터를 거쳐 디지털화된다.
  4. 전기적 신호를 그대로 전송하기 때문에 노이즈의 발생이 적고 품질이 좋다.
  5. 구조가 간단하여 화서 몇적 대비 포토 다이오드의 면적비를 크게할 수 있어, 고감도에서 S/N(Signal to Noise) 비가 뛰어나다.

정리

  CMOS 센서 CCD 센서
material CMOS 공정 (일반 반도체와 유사) CCD 전용 공정
전원 단일 전원 (0~3.3V), 저전력 복합전원 (0, 3.3, -7, 12V 등)
장점 주변 회로 집적성 우수 화질 우수
생산성 상대적으로 저렴, 대량생산 가능 상대적으로 고가, 대량생산 취약
  • 과거에는 CCD 센서를 디지털 카메라에 사용하고 CMOS 센서를 휴대폰에 활용하였다.
  • 모바일, 임베디드 시장이 커지면서 저전력으로 사용할 수 있는 CMOS 센서가 핵심 기술로 주목받았다.
  • CCD 센서는 아날로그 제조 공정을 거치고, CMOS 센서는 일반 반도체 공정을 거친다.
  • 제조가 간단하고 소형화가 가능한 CMOS 센서는 성능이 대폭 개선되었고, 동영상을 지원하고 가격이 저렴하기 때문에 디지털 카메라, CCTV 등에도 탑재되는 추세이다.

Reference

이미지: 나무위키(https://namu.wiki/w/CCD), SK하이닉스 뉴스룸(https://news.skhynix.co.kr/post/CMOS-Image-Sensor-innovation-led-by-SK-hynix)

내용: 라온피플 (https://blog.naver.com/PostList.naver?blogId=laonple)

'영상처리 > 이론' 카테고리의 다른 글

[영상처리 ISP] Demosaicing  (0) 2021.12.06

0. Introduction

딥러닝을 연구하다 보면 훈련시킨 네트워크를 검증하기 위한 데이터가 필요하다.

예를 들어, 나는 딥러닝 네트워크들 중 YOLOv2를 MATLAB 상에서 KITTI dataset으로 훈련시켰고 이를 KITTI에서 제공하는 다른 데이터셋(ex Tracking dataset) 등에서 검증하였다. 하지만 다른 데이터셋에서도 높은 성능을 보일 수 있는지 궁금했고 자율주행을 위한 훈련 데이터셋으로 유명한 BDD를 활용하고자 했다.

https://bdd-data.berkeley.edu/


Berkeley DeepDrive

Paper on the dataset is on arXiv and published at CVPR 2021 as an oral presentation. --> Please download at User portal!

bdd-data.berkeley.edu

Berkley DeepDrive dataset에서 tracking dataset은 JSON 파일 형식으로 지원되며, 총 10개의 클래스로 분류된다. 현재 Sequence 상황에서의 성능 향상에 관련된 연구를 진행하고 있기 때문에 구현한 코드를 검증하기 위하여 해당 데이터셋을 활용하기로 결정하였고, 이를 위해서는 MATLAB에서 사용가능한 형태로로 변환할 필요가 있었다.


직접 파일을 구현하는건 매우 귀찮은 과정이기 때문에 관련 자료를 찾아봤지만 찾지 못했고 어쩔 수 없이 손수 코딩해야 했다. 다른 사람은 이런 과정을 거치지 않았으면 해서 구현한 코드를 구현한다.


JSON 파일 내부에 있는 데이터를 2D 객체 검출에서 활용하는 Bounding box(x, y, widty, height) 꼴로 변환해야 하며 이를 table 형태로 변환하여 활용한다.


코드를 긁어서 사용해도 되고, 링크의 github에서 clone하여 사용해도 좋다.


코드는 BDD에서 제공하는 JSON을 table로 변환한다. 이는 최적의 코드가 아니며, 변환의 결과물이 중요하니 그냥 넘어가자.


1. MATLAB function code

bdd_label함수

더보기


function GT = bdd_label(fname)
% fname is labels root
fid = fopen(fname);
raw = fread (fid, inf);
str = char (raw');
fclose (fid);
data = jsondecode (str);

imageFilename = string([]);
Ped = {};
Rid = {};
Car = {};
Tru = {};
Bus = {};
Tra = {};
Mot = {};
Bic = {};
TraL = {};
TraS = {};
fname = strcat(fname(1:11),'images\track\train', fname(37:54));  % images folder root
for i = 1:size(data,1)
    imageFilename(i) = strcat(fname, '\', string(data(i).name));
    for j =  1:size(data(i).labels,1)
        if string(data(i).labels(j).category) == 'pedestrian'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            Ped(i,j) = C;
        elseif string(data(i).labels(j).category) == 'rider'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            Rid(i,j) = C;
        elseif string(data(i).labels(j).category) == 'car'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            Car(i,j) = C;
        elseif string(data(i).labels(j).category) == 'truck'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            Tru(i,j) = C;
        elseif string(data(i).labels(j).category) == 'bus'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            Bus(i,j) = C;
        elseif string(data(i).labels(j).category) == 'train'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            Tra(i,j) = C;
        elseif string(data(i).labels(j).category) == 'motorcycle'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            Mot(i,j) = C;
        elseif string(data(i).labels(j).category) == 'bicycle'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            bic(i,j) = C;
        elseif string(data(i).labels(j).category) == 'traffic light'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            TraL(i,j) = C;
        elseif string(data(i).labels(j).category) == 'traffic sign'
            C = {[data(i).labels(j).box2d.x1 data(i).labels(j).box2d.y1, (data(i).labels(j).box2d.x2-data(i).labels(j).box2d.x1), (data(i).labels(j).box2d.y2-data(i).labels(j).box2d.y1)]};
            TraS(i,j) = C;
        end
    end
end

Car = mcc(Car);
if size(Car,1) ~= 0
    Car(size(Car,1)+1:size(data,1),1) = {[]};
end
Rider = mcc(Rid);
if size(Rider,1) ~= 0
    Rider(size(Rid,1)+1:size(data,1),1) = {[]};
end
Pedestrian = mcc(Ped);
if size(Ped,1) ~= 0
    Pedestrian(size(Ped,1)+1:size(data,1),1) = {[]};
end
Truck = mcc(Tru);
if size(Truck,1) ~= 0
    Truck(size(Tru,1)+1:size(data,1),1) = {[]};
end
Bus = mcc(Bus);
if size(Bus,1) ~= 0
    Bus(size(Bus,1)+1:size(data,1),1) = {[]};
end
Motorcycle = mcc(Mot);
if size(Motorcycle,1) ~= 0
    Motorcycle(size(Mot,1)+1:size(data,1),1) = {[]};
end
Train = mcc(Tra);
if size(Train,1) ~= 0
    Train(size(Tra,1)+1:size(data,1), 1) = {[]};
end
Bicycle = mcc(Bic);
if size(Bicycle, 1) ~=0
    Bicycle(size(Bic,1)+1:size(data,1), 1) = {[]};
end
TrafficLight = mcc(TraL);
if size(TrafficLight,1) ~= 0
    TrafficLight(size(TraL,1)+1:size(data,1), 1) = {[]};
end
TrafficSign = mcc(TraS);
if size(TrafficSign,1) ~= 0
    TrafficSign(size(TraS,1)+1:size(data,1), 1) = {[]};
end
imageFilename = imageFilename';
GT = table(imageFilename);
if ~isempty(Car) ; GT.Car = Car; end
if ~isempty(Pedestrian) ; GT.Pedestrian= Pedestrian; end
if ~isempty(Rider) ; GT.Rider = Rider; end
if ~isempty(Truck) ; GT.Truck = Truck; end
if ~isempty(Train) ; GT.Train = Train; end
if ~isempty(Bus) ; GT.Bus = Bus; end
if ~isempty(Bicycle) ; GT.Bicycle = Bicycle; end
if ~isempty(Motorcycle) ; GT.Motorcycle = Motorcycle; end
if ~isempty(TrafficSign) ; GT.TrafficSign = TrafficSign; end
if ~isempty(TrafficLight) ; GT.TrafficLight = TrafficLight; end
end

bdd_label함수를 활용할 때 필요한 mcc함수

더보기
function MakeClasscell = mcc(arr)
    MakeClasscell = {};
    if ~isempty(arr)
        for l = 1:size(arr, 1)
            sav = [];
            for k = 1:size(arr,2)
                if ~isempty(arr{l,k})
                    sav(size(sav,1)+1,1:4) = arr{l,k};
                else
                    continue
                end
            end
            MakeClasscell(l,1) = {sav};
        end
    end
end 

2. 코드 설명 & 추가 활용법

input으로는 라벨의 경로를 넣어주면 된다. 이 파일을 사용할 때 주의해야 하는 점은 세 가지이다.

  1. 함수를 사용할 때는 파일의 확장자까지 넣어주어야 한다는 점을 기억해야 한다. BDD dataset의 라벨은 json 파일으로 제공되므로 'C:\User\users\...\abcd02020.json'와 같은 형식으로 함수의 인자에 넣어준다.
  2. mcc 함수 역시 github에 함께 올려 놓았으니 다운 받아서 사용하면 된다.
  3. 20번째 줄의 코드는 사용자에 따라 다를 수 있으니 이미지가 존재하는 폴더 경로로 변경해야 한다. (fname = strcat(fname(1:11),'images\track\train', fname(37:54));)


이를 활용해서 생성되는 것은 table 형식이며 이를 활용한 훈련이나 검증이 모두 가능하다. 하지만 혹여나 ground truth 형식으로 변환하고 싶다면(예를 들어, 훈련에 ground truth 형식의 변수가 필요하거나 image labeler 확장 앱으로 시각화하여 확인하고 싶다면) 아래의 코드로 ground truth 형식으로 변환할 수 있다.

'딥러닝 > 프로젝트' 카테고리의 다른 글

[Loss function] GIoU / DIoU / CIoU Matlab 코드  (0) 2021.12.07

Gao, Chen, Yuliang Zou, and Jia-Bin Huang. "ican: Instance-centric attention network for human-object interaction detection." arXiv preprint arXiv:1808.10437(2018).

1. Abstract

 사진을 보고 그 장면을 이해했다고 말하기 위해선 사람과 그 주변 물체가 어떤 상호작용을 하고 있는지에 대해 설명할 수 있어야 한다. 본 논문에서는 HOI(Human-object interactions)를 추론하는 작업을 주로 다루었다.

 각 영역의 형상(appearance)에 interaction을 예측하기 위해 주의 깊게 확인해야 할 영역에 대한 정보가 포함되어 있다. 이를 Attention map이라고 하며, 본 논문에선 이 영역을 강조하는 방법을 학습할 수 있는 모듈을 제안하였으며 이를 활용하여 전체 Context를 예측한다.


2. Introduction

Why HOI?

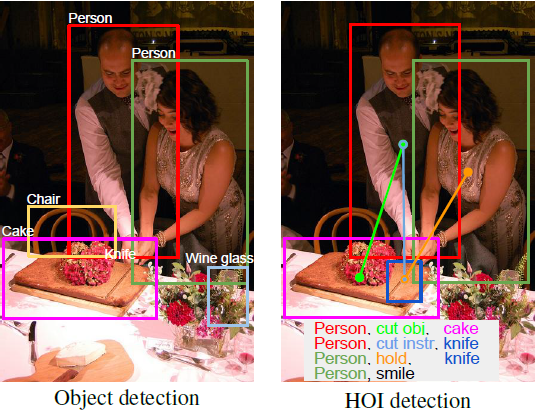
 위의 그림을 통해 HOI의 역할을 쉽게 이해할 수 있다. 입력 이미지와 감지기(Detector)에서 감지된 Attention region이 주어지면 이미지 내부의 모든 [사람, Verb(행동), 물체]의 triplet을 식별하는 것을 목표로 한다.


 HOI는 "어디에 무엇이 있는가?"의 관점이 아닌 "무슨 일이 일어나고 있는가?"에 초점을 맞춘 작업이라고 생각하면 이해가 편하다. 해당 기술을 연구하는 것은 Pose estimation, Image captioning, Image retrieval 등의 높은 수준의 작업에 대한 단서로 작용할 수 있다.


Why Attention map?

 최근 연구에선 사람과 물체의 형상이 어떤 영역에 관련이 있는지를 활용한다. 즉, 사람의 외형적 특징과 함께 동작을 인지하는 알고리즘을 사용한다면 더 정확한 문맥 추론이 가능할 것이다.


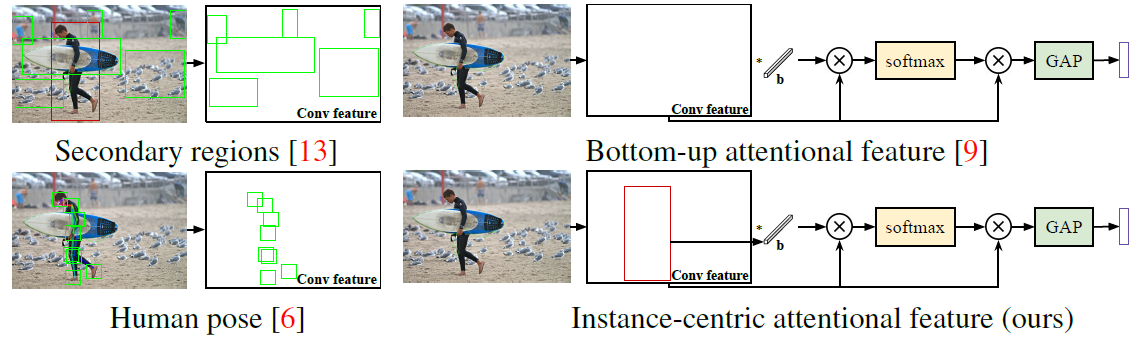
 예를 들어 위의 사진을 살펴보면 Context를 추측하기 위한 다양한 알고리즘들이 소개되어 있다. Secondary regions의 활용, 사람과 물체의 바운딩 박스의 결합 사용, 사람의 포즈의 키포인트 주변의 Feature 추출 등이 활용될 수 있다.


 이와 같은 방법들로 추출된 Context를 통합하여 Attention map을 구성한다면 당연히 성능이 향상될 것이다. 하지만 이 방식은 딥러닝으로 자동화 된 Attention map을 예측하는 기술이 아니며 사람이 직접 Attention region을 설정하는 방식이다. 이렇게 생성된 Map은 동작/상호작용을 인지하는 작업에 완벽할 수 없다. 상황마다 집중(Attention)할 영역이 달라지기 때문이다.


 예를 들어, '던지기'나 '타기'와 같은 동작을 식별하기 위해선 사람의 자세를 봐야할 것이고, '컵으로 마시기', '숟가락으로 먹기'와 같은 손과 물체의 상호작용과 관련된 동작을 인식하기 위해선 상호작용에 초점을 두어야 하며, '라켓으로 공을 치는 것'이나 '배트로 야구공을 타격하는 것'은 전체적인 배경에 집중해야 할 것이기 때문이다.


 최근 연구에서는 위의 한계를 해결하기 위하여 행동 인식 또는 이미지 분류를 위해 훈련 가능한 end-to-end Attention 모듈을 활용한다. 하지만 이러한 방법은 인스턴스 수준이 아닌 이미지 수준의 분류 작업을 위하여 설계되었다.


3. Instance-Centric Attention Network

  본 논문에선 HOI scores를 다음과 같은 식으로 계산한다.

 $S^a_{h,o}$ : HOI score

 $s_h, s_o$ : FasterRCNN으로 검출된 사람과 물체의 Confidence score

 $s^a_h, s^a_o$ : 검출된 형상(appearance)에 기반한 사람과 물체의 interaction score [Object/Human stream]

 $s^a_{sp}$ : 사람과 물체 사이의 spatial 관계에 기반한 interaction score [Pairwise stream]


 $s_h$는 FasterRCNN으로 검출된 사람의 confidence score이며 $s_o$는 물체의 confidence score이다. 사람의 행동을 예측할 때 웃는 사람 등 물체가 없는 경우도 검출할 수 있어야 하는데, 이 상황에서 HOI scores는 $S^a_{h,o} = s_h \centerdot s^a_h$가 된다.


3.1 Instance-centric attention module


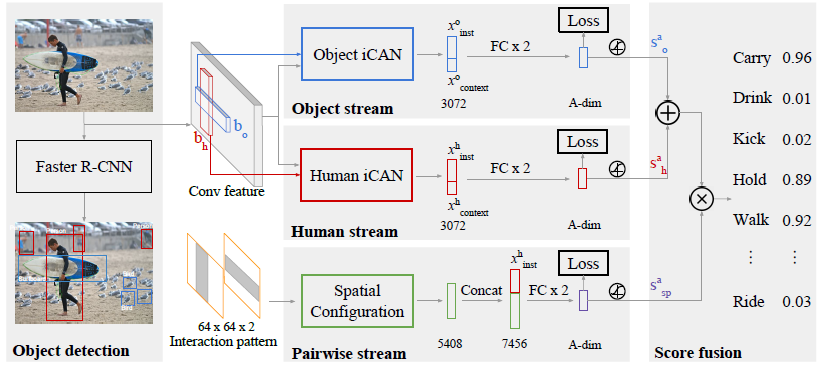
  1. 해당 모듈에선 FasterRCNN을 활용하여 생성한 Feature map(FM)을 활용하여 Context를 뽑아내는 과정이 이루어진다. 우선 FM에서 ROI pooling, res5 block, Global average pooling을 거쳐 인스턴스 레벨의 사람의 형상인 $x^h_{inst}$를 추출한다.
  2. 추출된 $x^h_{inst}$는 FC layer를 통과하여 512-dimensional 벡터가 되어 다시 FM과 dot production을 수행하여 유사도를 계산한다. 이후 softmax를 적용하여 Attentional map을 추출할 수 있다.
  3. 이 Attentional map과 기존 이미지를 dot production하면 HOI 작업에 활용할 수 있는 highlighting된 map을 구할 수 있다. 결과 값 역시 GAP를 거치고 FC 레이어를 거쳐 $x^h_{context}$ context 벡터를 만들며 이는 앞에서 구한 인스턴스 레벨의 $x^h_{inst}$ 벡터와 연결되어 사용된다.
  4. 이 벡터를 활용하여 $s^a_h, s^a_o$를 구할 수 있다.

이렇게 구성된 iCAN 모듈은 두 가지 장점이 있는데,

첫째, 다양한 알고리즘을 적용한 결과를 토대로 손으로 설계해야만 하는 Attention map과 달리 자동으로 Attention map을 생성하고 성능 향상을 위해 훈련될 수 있다.

둘째, image-level의 모듈과 비교하였을 때 instance-centric attention map은 다른 영역에 더 주의를 기울일 수 있으므로 더 유연한 활용성을 보인다.


3.2 Multi-stream network

 위의 그림을 보면 네트워크는 총 세 가지 stream(object, human, Pairwise stream)로 구성되어 있는 것을 볼 수 있는데, 3.1에서 본 과정이 Object/Human stream에 해당하는 과정이며 binary sigmoid를 통과시켜 최종 HOI score를 계산하기 위한 식에서 $s^a_h$와 $s^a_o$를 계산할 수 있었다.


 Pairwise stream에서는 two-channel binary image representation을 채택하여 상호작용 패턴을 추출한다. 사람과 물체의 바운딩 박스의 합집합을 reference box로 활용하여 그 안에서 두 개의 채널을 활용하는 방식이다. 첫 번째 채널은 사람 바운딩 박스 안에서 값 1을 가지며 다른 곳에서는 0을 갖고, 두 번째 채널은 물체 바운딩 박스 안에서 값 1을 가지며 다른 곳에서는 0을 갖는다. 그 후 CNN을 활용하여 이 2채널 이진 이미지에서 spatial feature를 추출한다.


 하지만 이 작업만으로는 정확한 동작 예측이 불가능하므로 인스턴스 레벨의 사람의 형태인 $x^h_{inst}$와 연결하여 binary sigmoid를 통과시켜 $s^a_{sp}$를 구한다. 그 이유는 사람의 형태가 비슷한 레이아웃(예를 들어 자전거를 옮기는 사람과 자전거를 타는 사람)에서 다른 행동을 판단하는데 도움이 되기 때문이다.


1. 소개

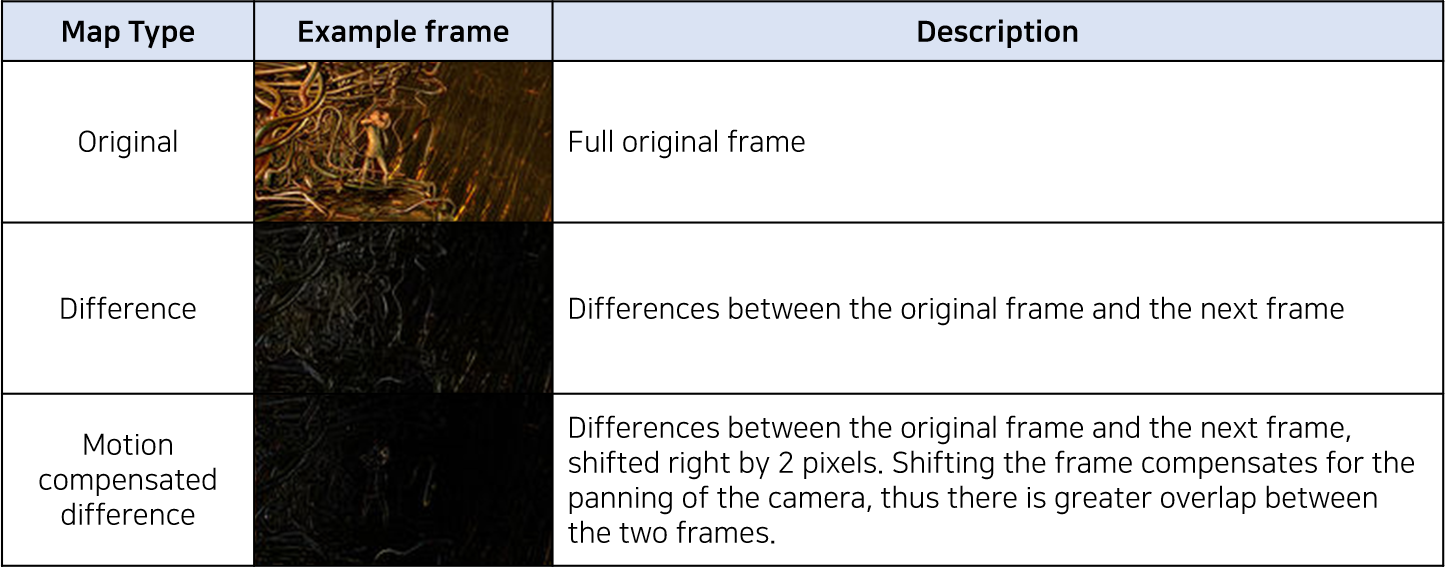
  Motion compensation은 연속된 영상의 두 프레임의 차이가 카메라가 움직이거나 물체가 움직인 결과라는 사실을 활용한다. 이는 한 프레임을 나타내는 정보들이 다음 프레임에서 사용되는 정보와 동일함을 의미한다.

  움직임 보상은 대부분의 동영상 압축 기술(MPEG-2 등)에 적용되고 있는 기술이다. 현재의 영상을 부호화하기 위하여 기존의 부호화 된 영상을 가져와서 예측을 하기 위하여 사용된다. Motion Estimation은 Motion compensation을 위해 Motion vector를 찾는 기술을 의미한다. 이와 비슷하게 비디오를 압축하는 기술은 Discrete Cosine Transform(DCT)이 있다.

  아래의 내용은 Wikipedia를 참고하여 작성되었다.


2. 기능

  Motion compensation은 보통 두 개의 연속된 프레임의 차이를 Difference map으로 추출하고 해당 map을 활용하여 이전 프레임과 현재 프레임 간의 shift vector를 재추출하여 Motion compensated difference map을 구한다. 두 프레임 간의 움직임 벡터만을 뽑아낸 MCD map은 이미지 자체를 활용하는 것보다 더 적은 정보를 담고 있으므로 이를 활용하면 영상의 압축이 가능하다. 따라서 보상된 프레임을 인코딩하는데 필요한 정보는 Difference map보다도 훨씬 작다.

출처: 위키피디아


3. Global Motion Compensation(GMC)

  Motion 모델은 기본적으로 다음과 같은 카메라 움직임 특성들을 반영한다.

  • Dolly: 카메라를 앞뒤로 이동
  • Track: 카메라를 왼쪽 또는 오른쪽으로 이동
  • Boom: 카메라를 위 또는 아래로 이동
  • Pan: Y축을 기준으로 카메라 회전, View를 좌우로 이동
  • Tilt: X축을 기준으로 카메라 회전, View를 위아래로 이동
  • Roll: Veiw(Z) 축을 기준으로 카메라 회전

해당 보정 과정은 물체가 없는 스틸씬에 적합하며, 몇가지 장점을 가지고 있다.

  • 몇 개의 파라미터만 가지고 비디오 시퀀스에서 주요 움직임들을 모델링이 가능하다. 파라미터들의 비트 전송률 점유율 자체는 무시가 가능하다.
  • 프레임을 분할하지 않기 때문에 흔적이 남지 않는다.(여기서 artifacts를 흔적으로 의역하였음. artifacts가 존재할 경우 연속성 X)
  • 프레임에서 시간축에 해당하는 직선을 따라 실제 영상은 연속적으로 움직인다. 다른 Motion compensation 체계는 시간 방향에 불연속하다.

  MPEG-4 ASP(코덱이라고 보면 될듯)은 세 개의 참초 포인트가 있는 GMC를 지원하지만 보통 하나만 사용 가능하다. 단일 기준점을 사용하면 상대적으로 큰 성능 비용이 발생하여 뒤에 나올 Block motion compensation에 비해 거의 이점이 존재하지 않는다. 또한, 프레임 내에서 움직이는 물체를 표현할 수 없기 때문에 Local motion estimation도 필요하다는 단점이 존재한다.


4. Motion-compensted DCT

  Block motion compensation(BMC)은 motion-compensation discrete cosine transform(MC DCT)라고도 하며, Motion compensation 테크닉으로 가장 많이 사용된다. BMC는 프레임을 이미지의 픽셀들을 블록을 나누는 방식을 활용한다.(예를 들어 MPEG에서는 16x16 픽셀 사이즈의 macro-block을 사용함) 각각의 블록은 기준 프레임에서 동일한 사이즈의 블록으로부터 각각의 블록들의 움직임을 예측한다.


  인접한 블록 벡터들이 단일 이동 객체에 그려지게 되면 해당 벡터들은 중복되는 성질을 갖게된다. 이를 활용하기 위해 비트스트림(bit의 시계열)에서 현재 및 이전 Motion vector 간의 차이만 인코딩하는 것이 일반적이다. 이 과정의 결과는 패닝이 가능한 글로벌 움직임 보정과 수학적으로 동일하다. 인코딩 파이프라인 뒤에서 엔트로피 인코더는 출력 크기를 줄이기 위하여 영벡터 주변의 움직임 벡터에 대한 통계적인 분포를 활용한다.


  정수가 아닌 픽셀 수만큼 블록을 이동할 수 있기 때문에 하위 픽셀 정밀도라고 한다. 중간 픽셀은 인접 픽셀을 보간하여 생성되며, 일반적으로 절반 픽셀 또는 1/4 픽셀 정밀도가 사용된다. 보간에 들어가는 연산량과 인코더에서 평가할 소스 블록 수가 많기 때문에 서브 픽셀 정밀도의 계산 비용이 훨씬 더 크다.

  BMC의 주요 단점은 불연속성을 도입한다는 것이다. 블록으로 인해 블록 가장자리가 수평/수직 모서리로서 사람의 눈에도 쉽게 감지되고 푸리에 변환 계수의 양자화(quantization)로 인해 edge 현상 및 Ringing 현상이 발생한다.


  BMC는 현재 프레임을 겹치지 않는 blocks로 나누고 motion compensation vector로 부터 이 블럭들이 이전 프레임의 어디서 왔는지, 어디로 이동할지를 알 수 있다.

  추가로 삼각형 타일을 Motion compensation에 활용하는 방법도 제안되었다. 프레임은 삼각형으로 타일화 되고 다음 프레임은 이 삼각형들의 아핀 변환으로 생성된다. 이 과정에서 Affine 변환만이 기록/전송되며 확대/축소, 회전, 변환 등을 처리할 수 있다.

1. 이론 설명

  DBSCAN(Density-Based Spatial clustering of applications with noise)은 대표적인 밀도 방식의 클러스터링 기법이다. 군집 간의 거리를 이용하여 클러스터링을 하는 대표적인 알고리즘은 K-means와는 달리, 밀도를 호라용한 클러스터링은 점이 모여있는 영역을 합쳐나가는 방식이다.


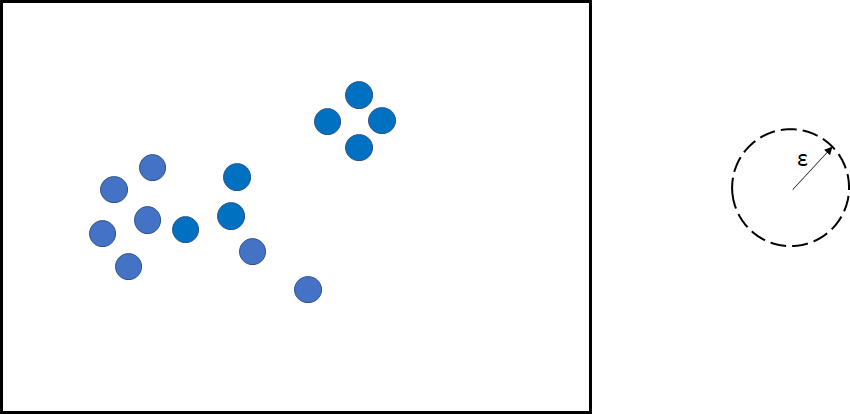
  각 점 데이터가 2D/3D로 흩뿌려져 있다고 가정하면 상태는 아래와 같다. 아래와 같은 데이터를 DBSCAN 알고리즘을 활용하여 클러스터링 하기 위해선 두 가지 파라미터 $\epsilon, n$을 설정해야 한다.


epsilon으로 인접하다고 판단하고 점군 데이터를 묶어줄 바운더리를 설정한다. (좌) 처리 전 점군 데이터, (우) 설정한 epsilon 데이터로 생성한 바운더리


  $\epsilon$은 처리할 벡터로 부터 인접한 벡터들을 묶기 위한 거리 파라미터라고 생각하면 편하고, $n$은 해당 거리인 $\epsilon$ 안에 point가 몇 개가 있을 때 함께 묶어서 군집화 할 지를 정하는 개수 파라미터이다.


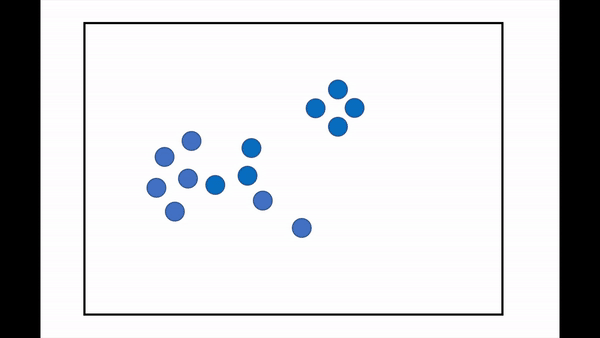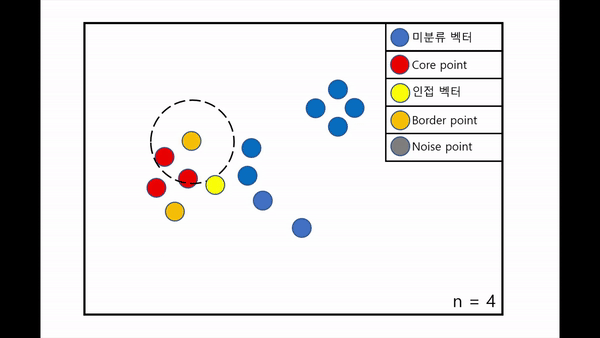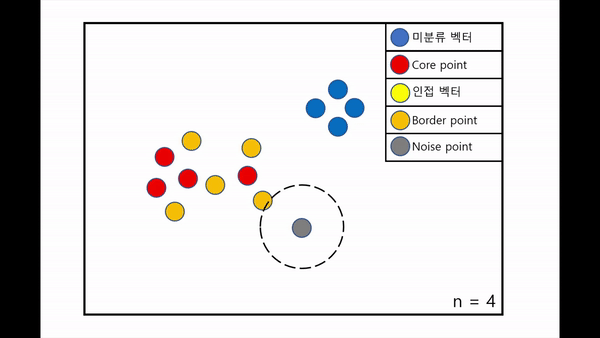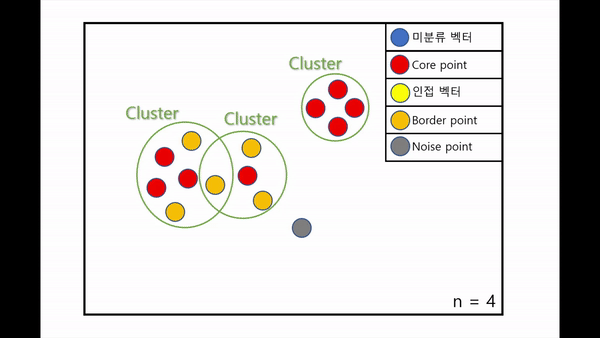
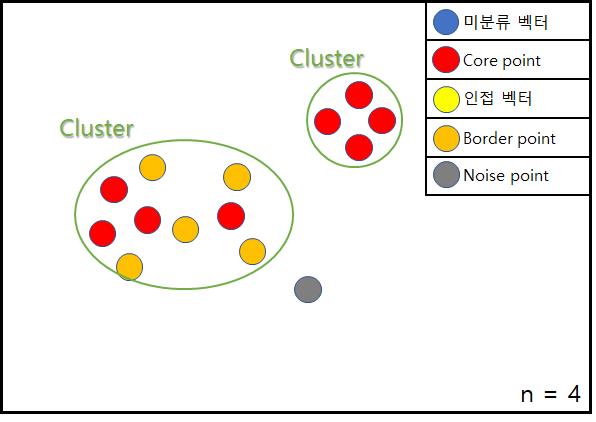
  위의 두 가지 파라미터를 설정하였다면 DBSCAN Clustering을 진행할 수 있다. 해당 알고리즘을 수행할 때 벡터를 분류하는 기준은 총 4가지가 존재한다.

  • 인접 벡터 : 현재 처리하고 있는 Point에서 $\epsilon$ 반경을 갖는 원을 그렸을 때, 그 원 내부에 존재하는 점 벡터
  • Core point : 자신을 포함한 인접 벡터의 수가 $n$개 이상인 점 벡터
  • Border point : 가장자리 벡터라고 생각하면 편하며, Core point에 연결되어 있으나 자기 자신은 Core point가 아닌 점벡터
  • Noise point : 다른 Core point와 연결도 되지 않고, 자기 자신도 Core point가 아닌 점벡터

또한 클러스터링을 진행할 때 적용되는 특성은 두 가지가 존재한다.

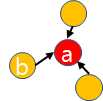
  • Density-reachable : Core point a와 a와 연결된 인접 벡터 b에 대하여 b는 a에 접근 가능하다. 하지만 b가 Core point가 아닌 경우엔 a에서 b로는 접근이 불가능하다.
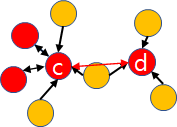
  • Density-connected :  어떠한 점벡터 c와 d에 대하여 c와 d에 접근 가능한 벡터 v가 존재할 때, c와 d는 서로 연결되어 있다.


2. 알고리즘 진행 과정

  위의 특성들을 모두 반영하여 클러스터링은 아래와 같이 진행된다.


  여기서 Density-connected 특성까지 반영하면 최종 클러스터링 결과는 아래와 같다.


3. 결론

  DBSCAN 알고리즘은 주어진 데이터들에 대해 각각의 데이터들을 세 가지(Core, Border, Noise)로 분류하는 것으로 K-Means Clustering에 비교해봐도 상당히 명확한 기준을 가지고 있는 것을 볼 수 있다. 실제로 각각의 데이터들을 분류하기 위한 거리인 $\epsilon$ 내의 데이터들의 숫자를 파악하고 또한 그 데이터들을 추가 분류함으로서 순차적으로 분류해나갈 수 있다.

  K-Means와 비교하여 DBSCAN은 군집의 개수를 정의할 필요도 없으며, 군집의 형태에 영향을 받지 않는다. 또한 Noise를 따로 분류하고 영향을 받지 않기 때문에 더욱 명확한 분류가 가능하다.

  하지만 다양한 밀도를 가지는 데이터의 분류에 적합하지 않고, 고차원 데이터에 대해서 적절한 $\epsilon$ 값을 찾기 어렵다는 단점도 존재한다.


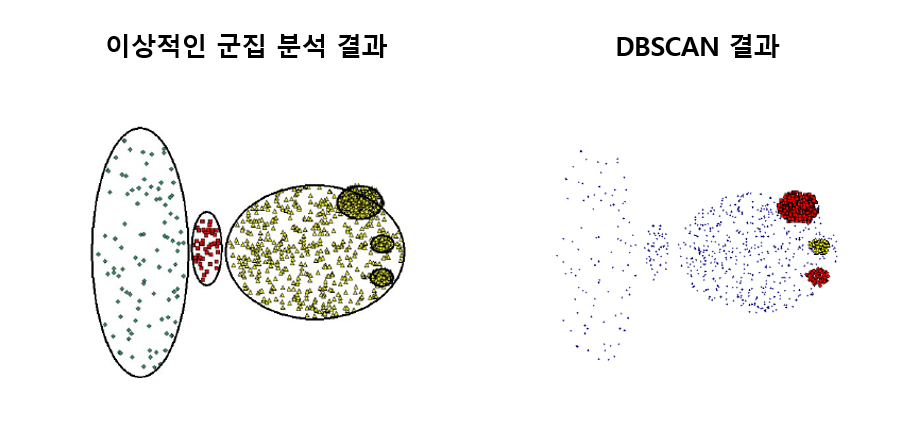
  적합한 $\epsilon$ 값은 k-distance graph를 활용하여 구할 수 있다. 좋은 $\epsilon$ 값은 묶인 데이터들끼리 강력한 기준에 부합되게 분류되는 값이며, 극단적으로 크면 한 군집만이 만들어지고 작으면 대부분의 데이터가 클러스터링 되지 않을 것이다. 아래의 사진은 출처의 블로그에서 다양한 밀도의 데이터에 대해 DBSCAN Clustering 작업을 수행한 결과이다. 밀도가 높은 곳에 집중하기 때문에 밀도가 낮은 곳을 하나의 클러스터로 인식하지 못하고 노이즈로 처리한 모습을 볼 수 있다.


출처: 마케터 루시씨 블로그, "https://lucy-the-marketer.kr/ko/growth/%ED%81%B4%EB%9F%AC%EC%8A%A4%ED%84%B0%EB%A7%81%EA%B3%BC-dbscan/"


나아가 DBSCAN을 만든 사람이 더 이상 Border point의 정의가 없는 HDBSCAN(hierarchical DBSCAN)을 게재하였다고 한다.


'딥러닝 > 공부' 카테고리의 다른 글

[Clustering Algorithm] KNN 알고리즘  (0) 2021.12.07
[영상 처리] Motion compensation(움직임 보상)  (0) 2021.05.21
Attention mechanism의 이해  (0) 2021.04.08

+ Recent posts